分享分为3部分。首先我分享三个通用的人与 AI 协同方法(第2节)。然后通过一项实际业务——亚运图文直播召回,分享如何从零获得一个自动化执行的skill(第3节)。最后分享我一个月以来使用AI工具的想法(第4、5节)。希望你会有收获。
OpenAI 与 Anthropic 家的消息各一则
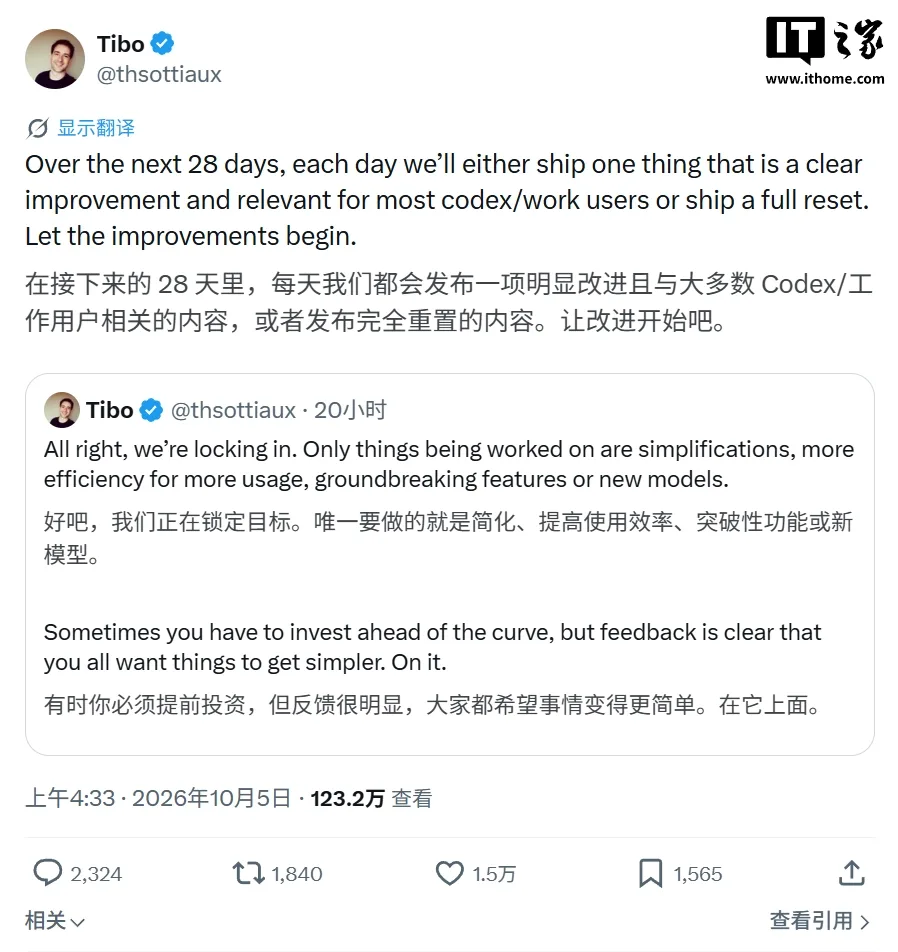
OpenAI 28天计划:每日一大更,不满意就全球重置。
2026.10.05,OpenAI 核心产品与平台负责人 Thibault Sottiaux 今日在 X 上发文,透露团队将在未来 28 天持续推进 Codex 和 ChatGPT Work 相关改进。
他表示,OpenAI 接下来每天都会发布一项“对大多数 Codex / Work 用户而言有明显改善且具备实际意义”的功能更新,否则就提供一次“重置”。
截至10.11日进展:5号-默认推理提速;6号-重置;7号-GPT-6在 ChatGPT发布、重置;8号-实时纠偏更快;9号-输入框预测、Dot;10号-重制;11号-Sol 默认上下文扩大、无附加费
Anthropic opus 5.5 生成了让人“震惊瘫坐”的视频:
prompt-《我从未见过太阳》
那接下来你设计一个剧本,做一个3-5分钟左右的短片吧。我希望是那种在戛纳能获奖的、史诗级别、宏大场面、优秀的剧本、有深刻意义、又能展示出opus5.5剧本设计镜头设计导演功底的镜头语言充分的小短片吧。总是要惊艳众人,开场可以好莱坞级别的,比如背景音、字幕切换等,开头就可以展示出本片由opus 5.5制作,不用一次性出场,可以有合适的镜头、融入界面就会更高级等等。有什么不明白的你可以和我沟通清楚再开工,推进视频落地等你看看要不要用opus5.5 high来执行,剧本设计、镜头等重要的内容要不要用opus5.5 max,这些子agent的安排由你来,但是我希望合理的使用token,但是还是要保证品质,因为我们要靠这个片子获奖。每一帧画面、每一个音符都由Opus 5.5 写代码生成:WebGL/Three.js 渲染3D、粒子和光影,代码合成音乐和音效,最后自动剪辑成片。
叙事靠镜头、音乐、音效和少量电影字幕卡(中英双语)
1 从一件琐碎、量大的工作开始
从我的具体任务讲起...
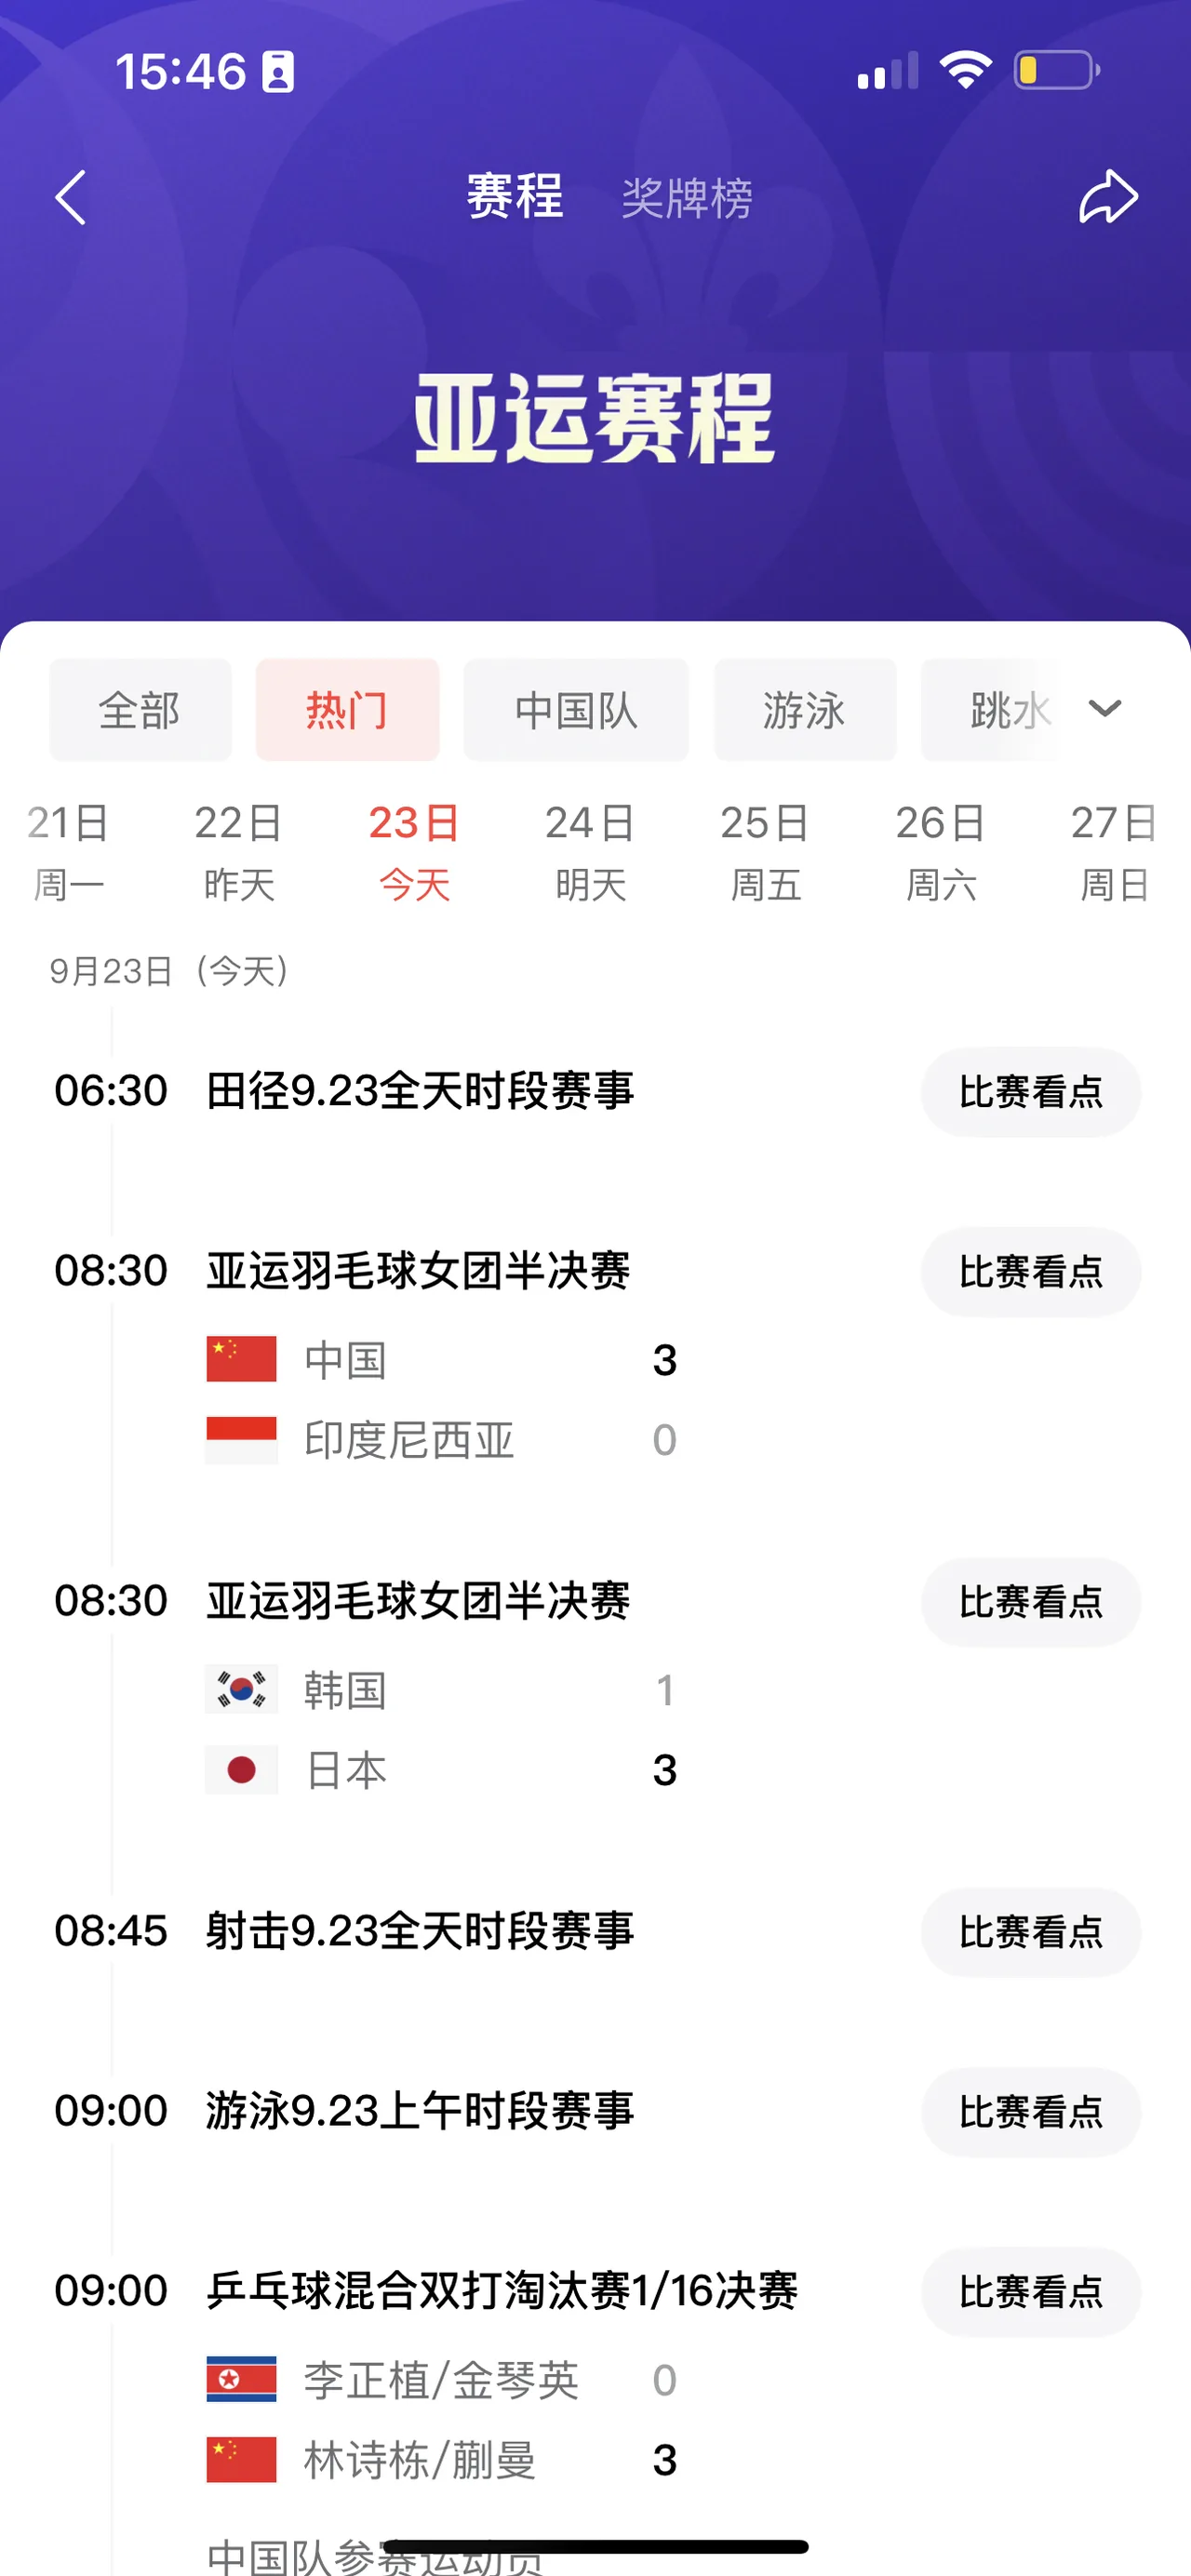
我的业务视角还有限,所以先从一个具体任务讲起:官老师交给我的亚运图文直播召回工作。它需要为头条客户端亚运赛程二级页配置热点资讯召回关键词,工作流程是找赛程、配置关键词、配置发布、客户端验收、配置微调和配置管理。
人工配置方式 / 为头条客户端-亚运-赛程二级页配置热点资讯图文召回的关键词
- excel表管理所有赛事的召回配置信息
- 头条体育 or 字节热点中台,同步差分赛程和Hotrio映射,将新增/更新的Hotrio加入处理队列
- 对每一条赛程:
- 字节热点中台,筛选检索到赛事条目
- 经过三次点击,进入hotrio页面-区块管理页
- 定位到「热点资讯」区块,编辑主内容:配置排序方式、关键词匹配、召回关键词、最近发文时间等
- 提交-发布-确认
- 验证:手机端查看召回效果
- 回流:excel登记配置情况与实际召回效果
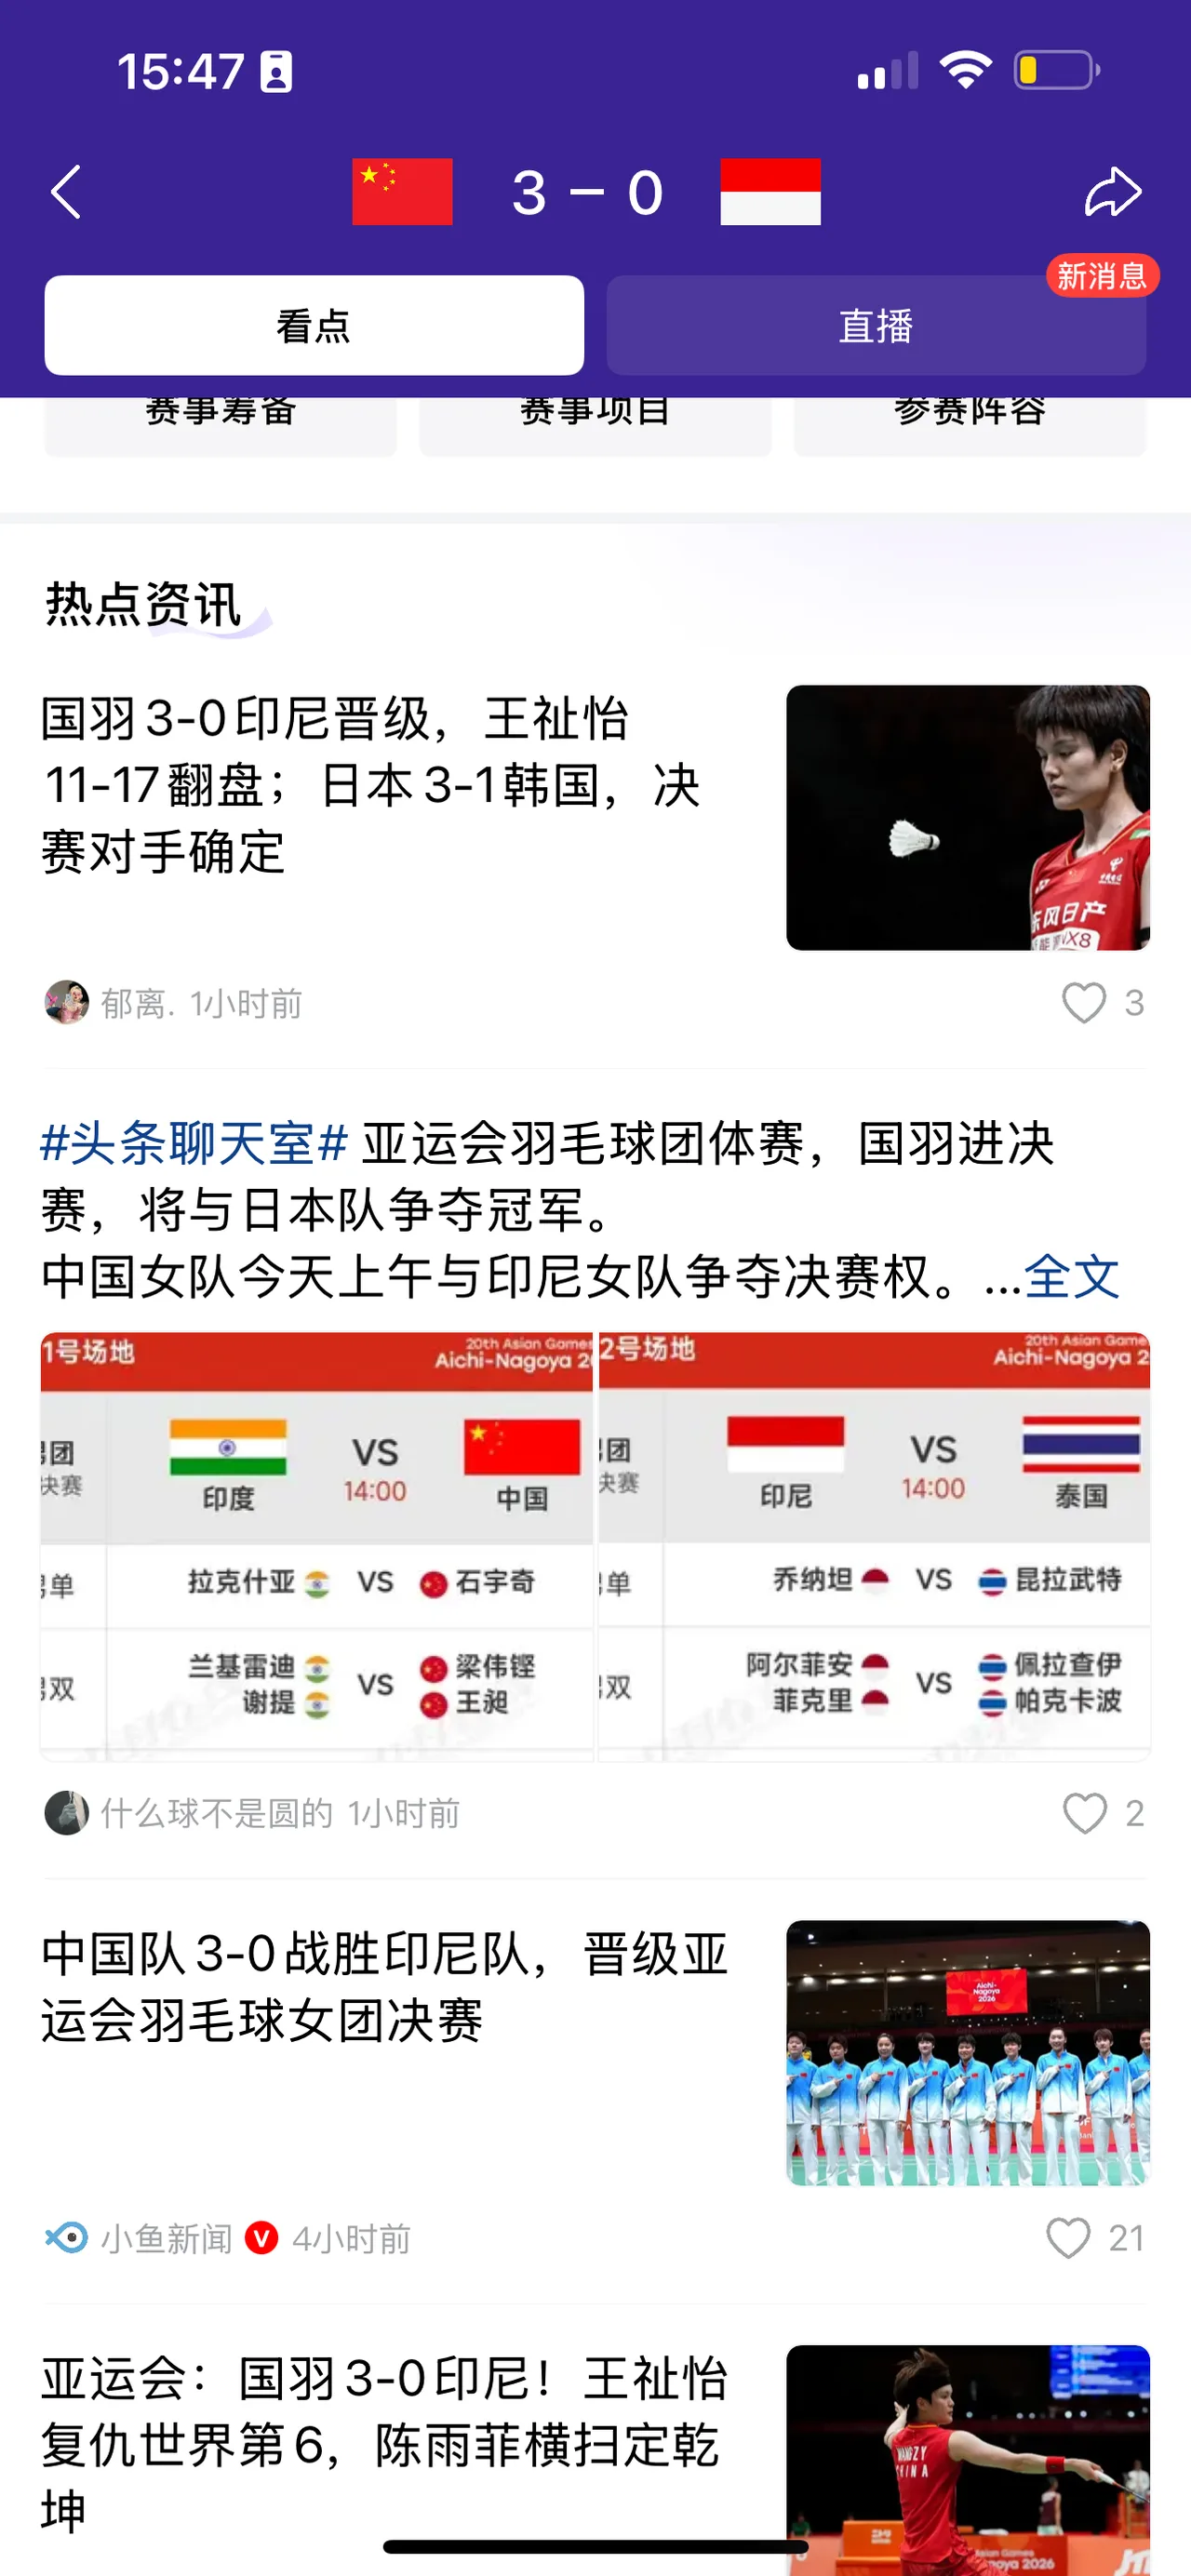
工作量背景:
- 琐碎:每一条赛程配置需7步操作,通过中台配置的试验表明,单条配置平均耗时22.2s、等待平均耗时19.8s,总计42s(已优化流程后、流水线配置极限速度)
- 量大:10.05日统计线上共计1202条赛事;每天更新0~100余条
- 有一定周期:亚运会期间,从9月16日接手至10月4日,共计19天;预判每天都有增补项目。
- 前面三条都不是主要问题,真正的问题是赛程数据与配置状态的同步与管理几乎无解。中台不提供最近更新字段和排序视图,上千条赛事要持续更新。每次都需全量排查,300条以内耗时且易遗漏;超过300条几乎无法手工核对,必须诉诸工具。
这件事很适合作为AI协作的起点:操作量大,步骤重复,同时又有明确的业务规则和可检查的结果。同时,由于它具有一定的时间跨度(持续19天,而不是三天五天),因此值得固化成SOP、进一步花时间和精力去设计和迭代智能体,实现智能自动化。
让 AI 承担重复操作,把自己的时间更多留给理解业务、生产关键配置、判断例外和检查质量。
附 手动操作SOP
序号 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10(只能人工) |
步骤 | 头条体育->亚运会->比赛->筛选->查询
| 3.1 关闭「跳转时同步切换列表」 3.2 进入直播间 | 完整Tab配置 -> 看点应用 -> 进入Hotrio ID | 字节热点中台 -> 区块管理 | 编辑「热点资讯」 | 干预热点资讯召回内容列表 右侧表单最下面一行:热点资讯-操作列「编辑」 排序方式:时间序 召回关键词:尽可能准 & 避免无召回内容 最近发文时间:7天 提交 | 干预看点集锦 右侧表单最上面一行:看点集锦-操作列「编辑」 | 发布:发布刚刚编辑的「热点资讯」和「看点集锦」 | 检查线上效果 | |
图片 | 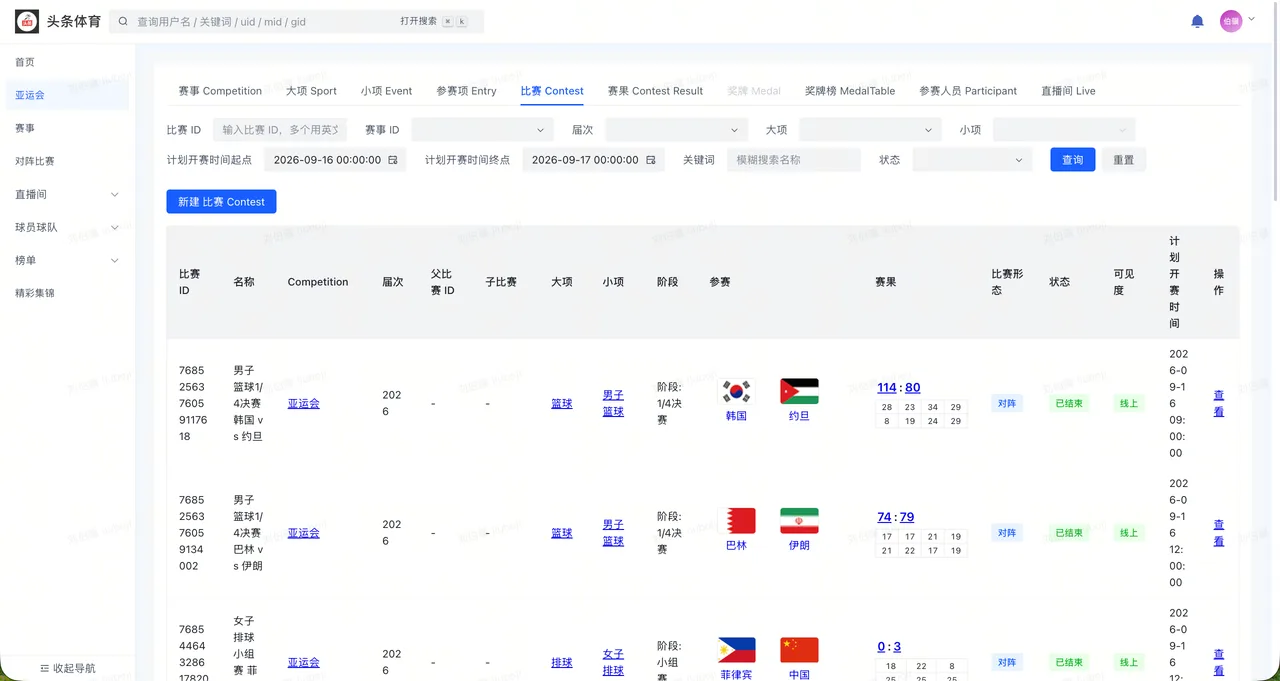 | 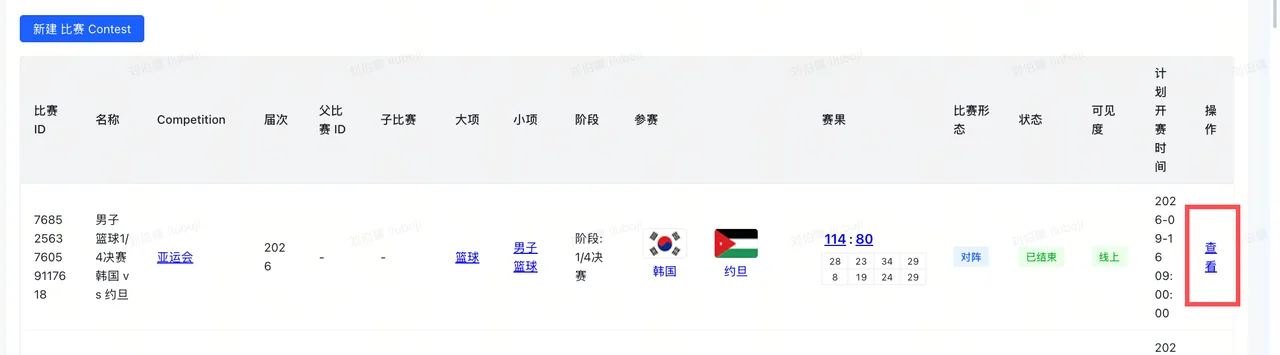 | 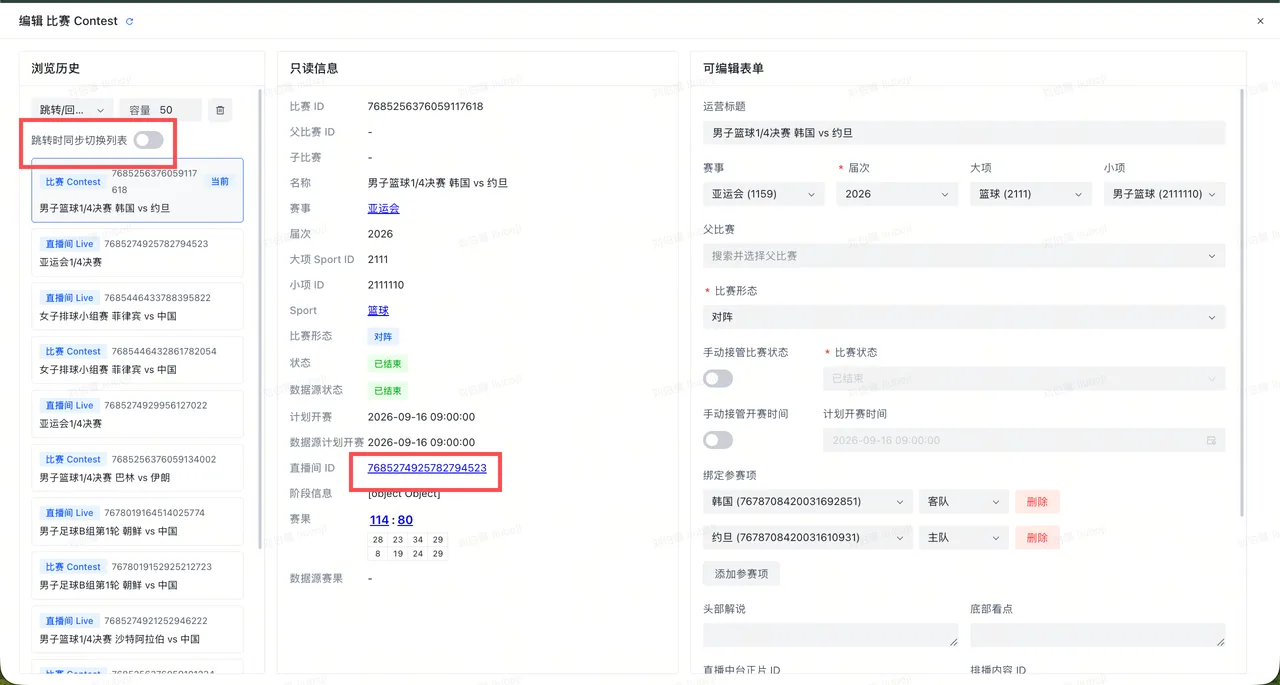 | 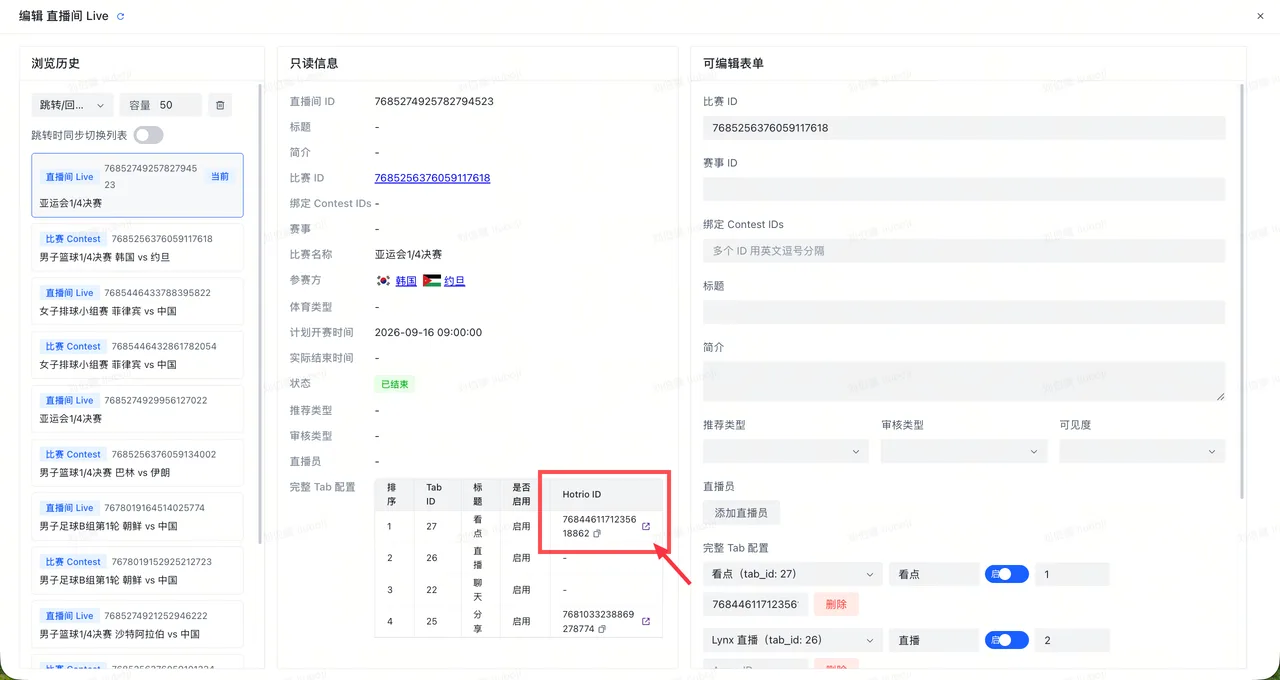 | 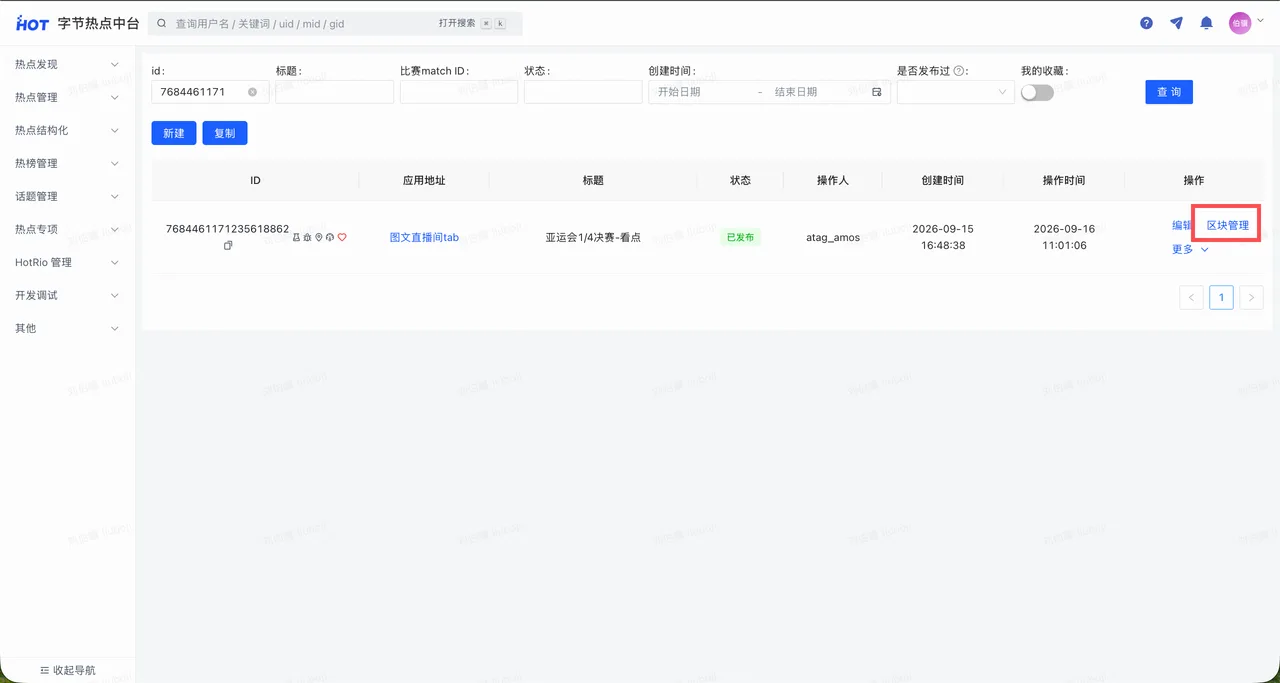 | 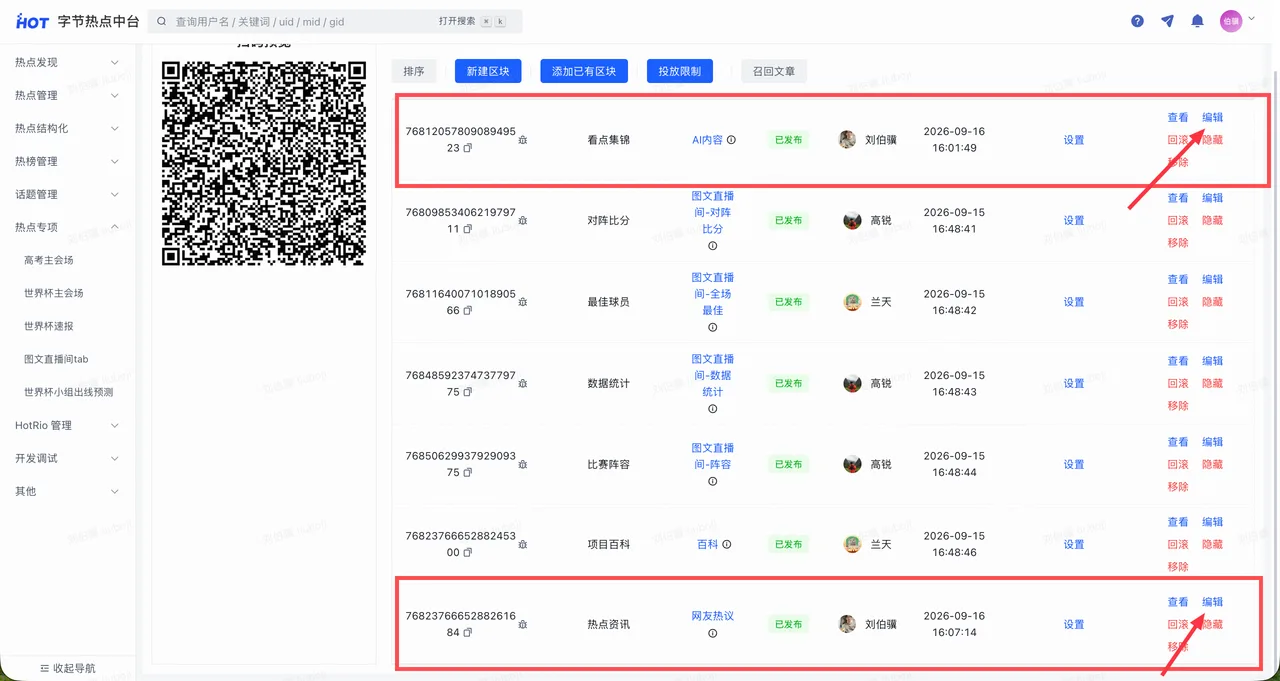 | 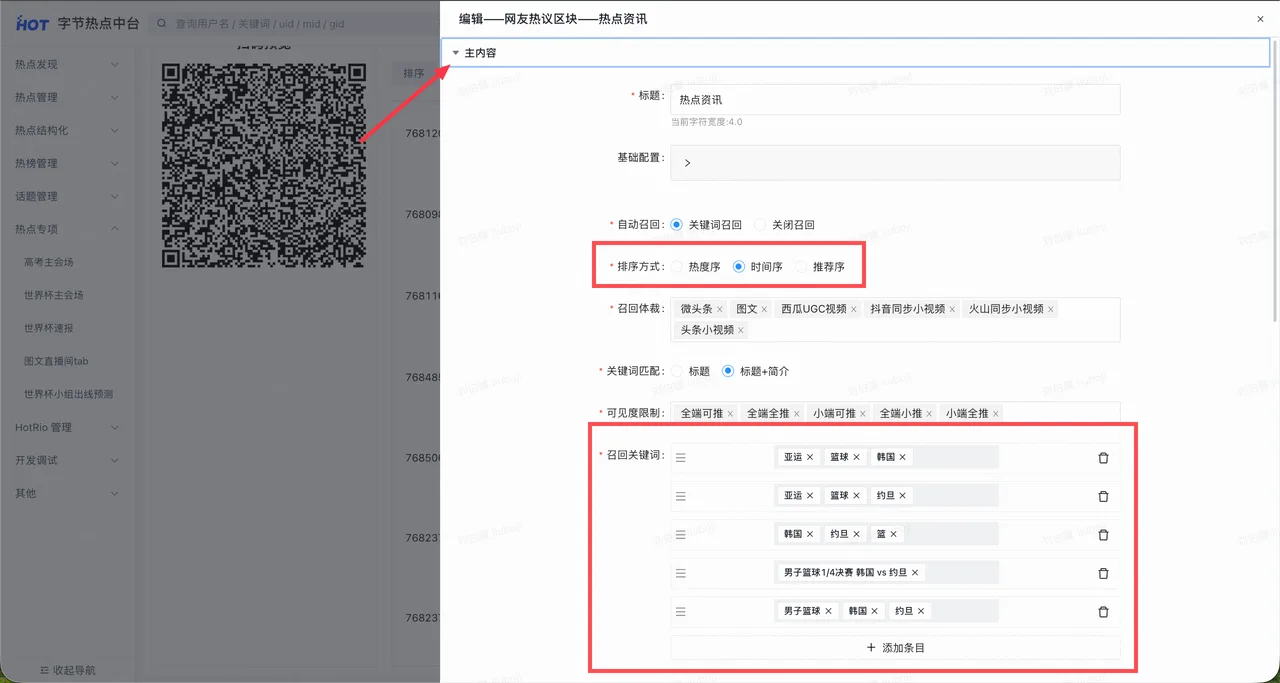 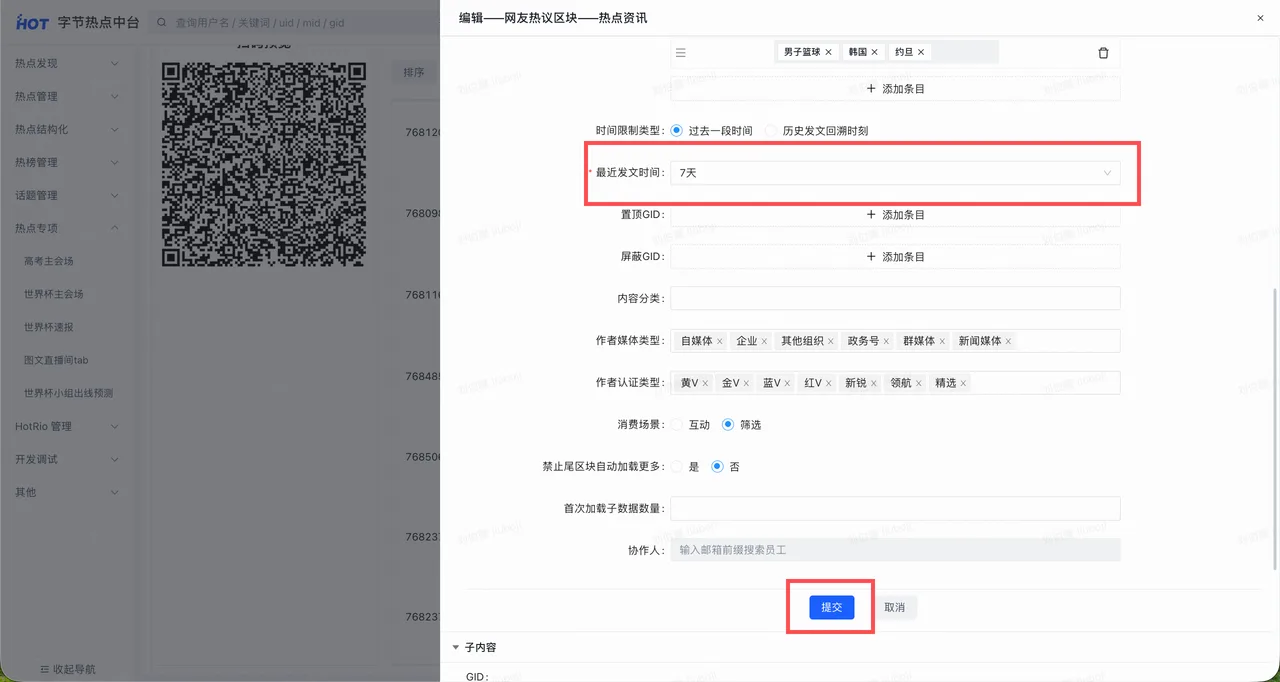 | 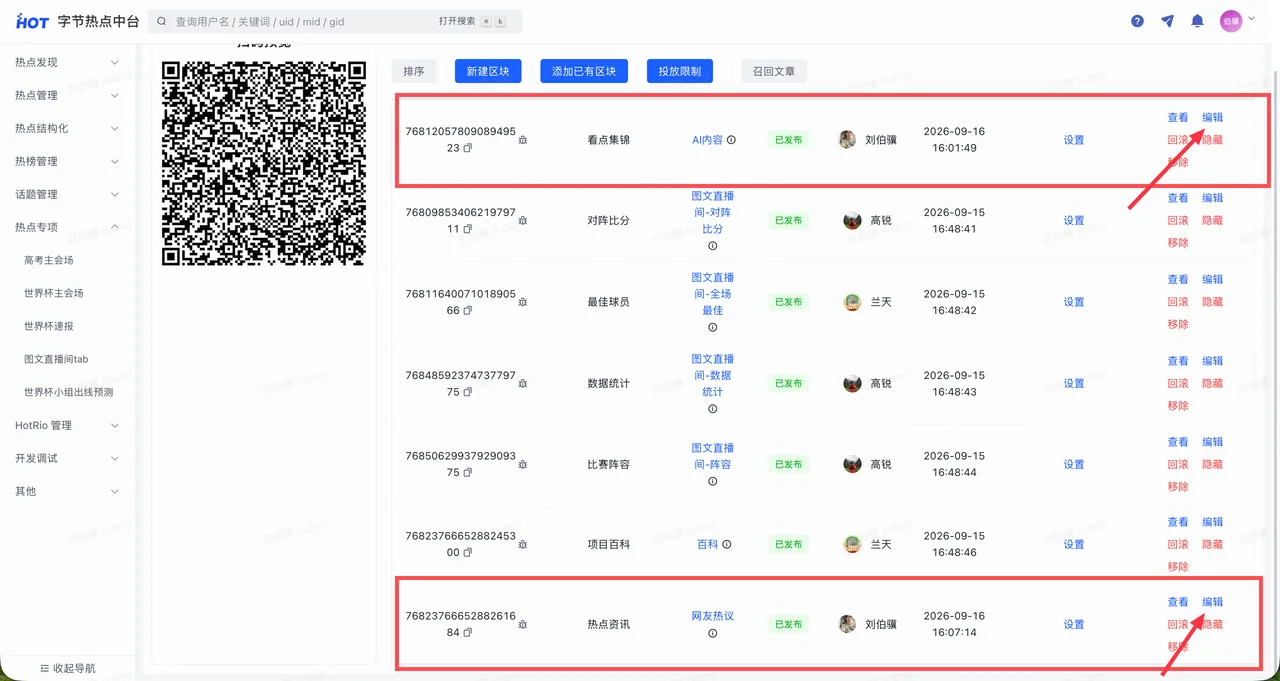 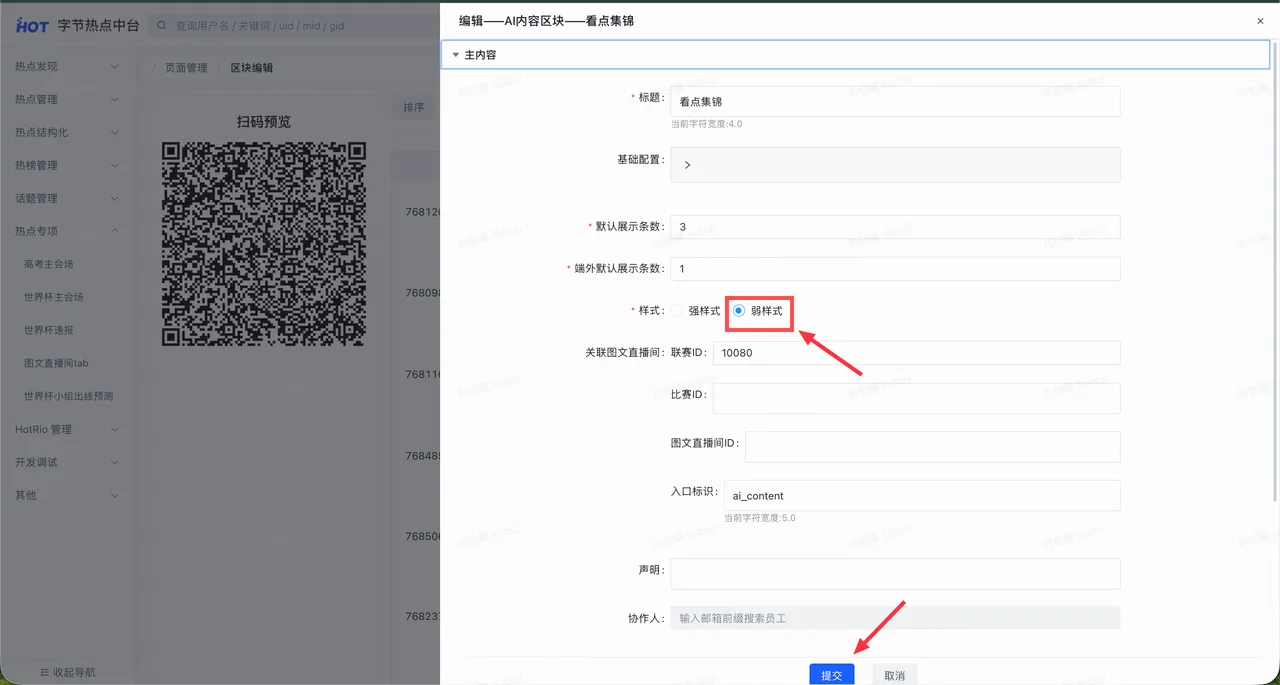 | 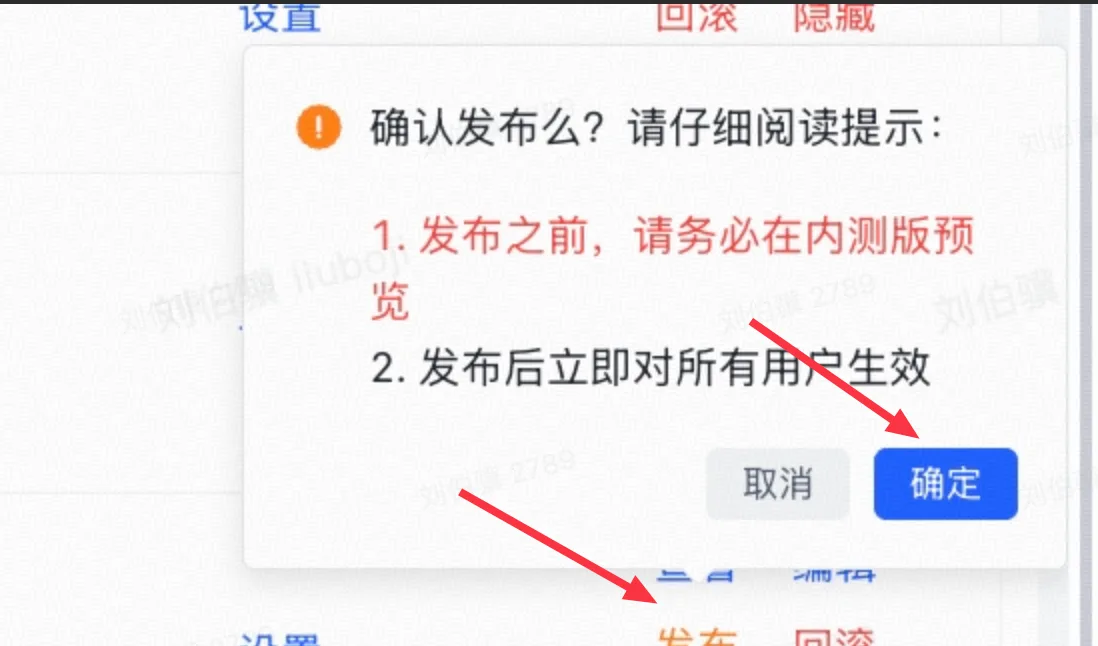 | 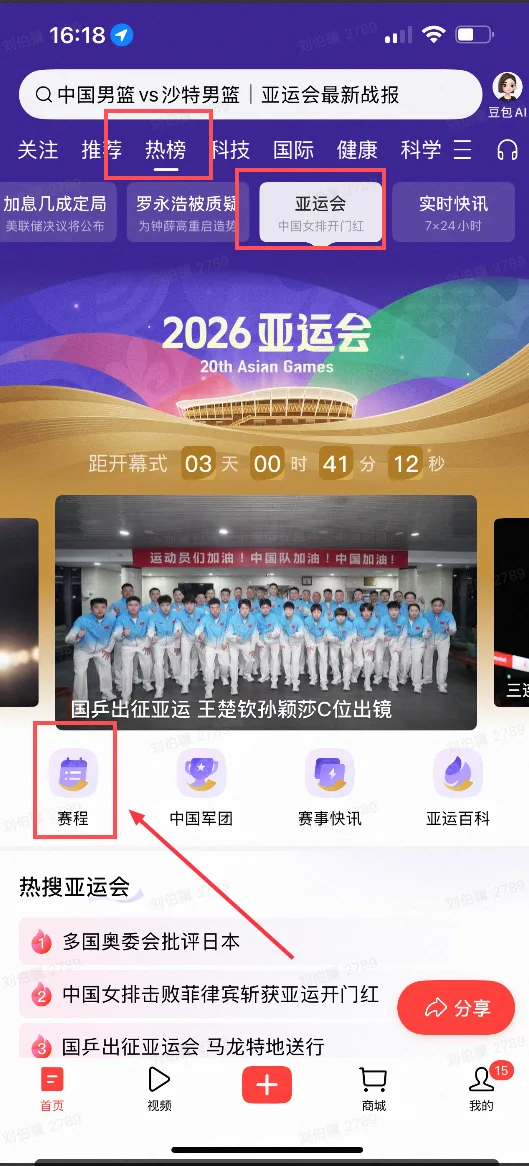 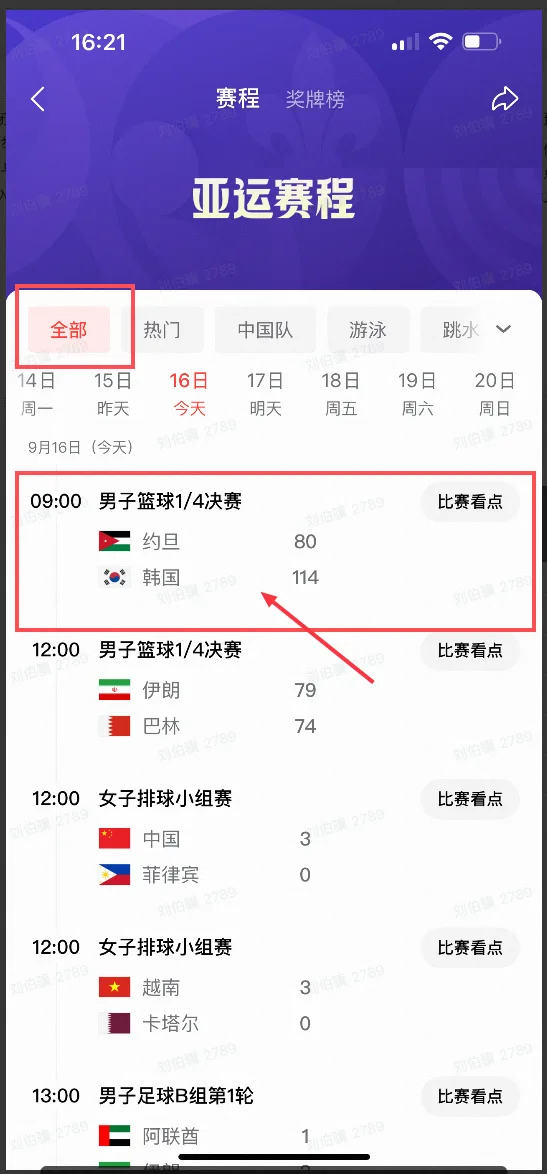 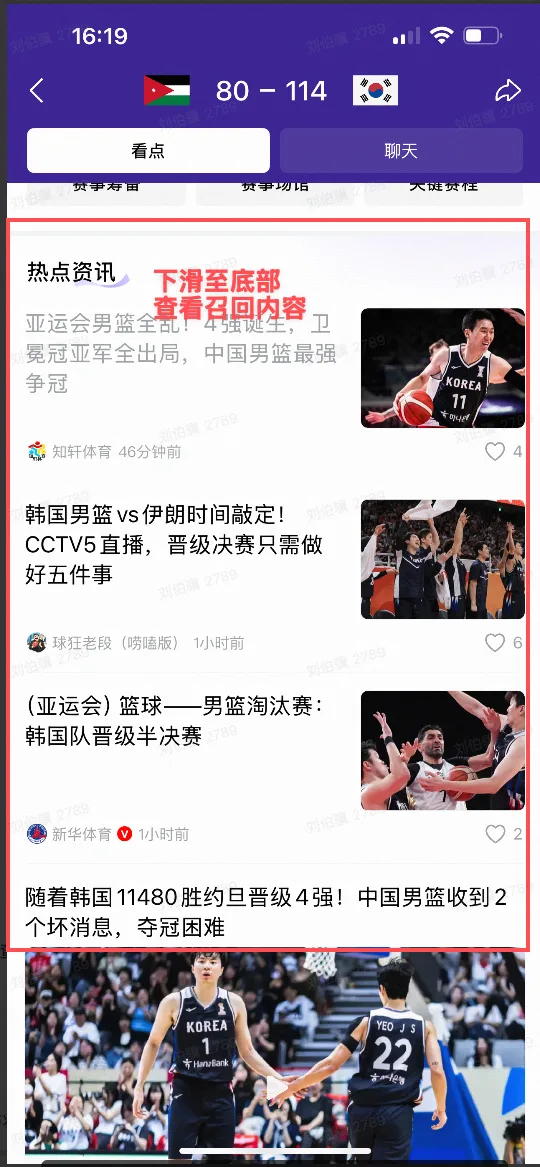 |
2 三个技巧
/ 人xAI协同办公:🖼️留背景-🚏留流程-🙅留错误
在分享具体例子之前,我想先分享三个使用 AI 工具与协作的小技巧;在具体例子环节,会看到它们如何起作用。
留背景,让 Agent 获得长期记忆、避免遗忘,支撑深度理解。
留流程,让 Agent 获得更多确定性,做一个形成肌肉记忆的熟手,把精力(or带宽)和上下文窗口更多地留给创造。
留错误,让 Agent 能“长记性”,并支持更快找到成功路径。
2.1 🖼️留背景
/ 一业务一项目 让下一次直接继续
痛点:持续做一个业务,新的任务往往依赖之前的背景、规则和决定。如果这些信息只在聊天里,换一次会话就需要重新输入,或者漏掉重要限制。
怎么做?
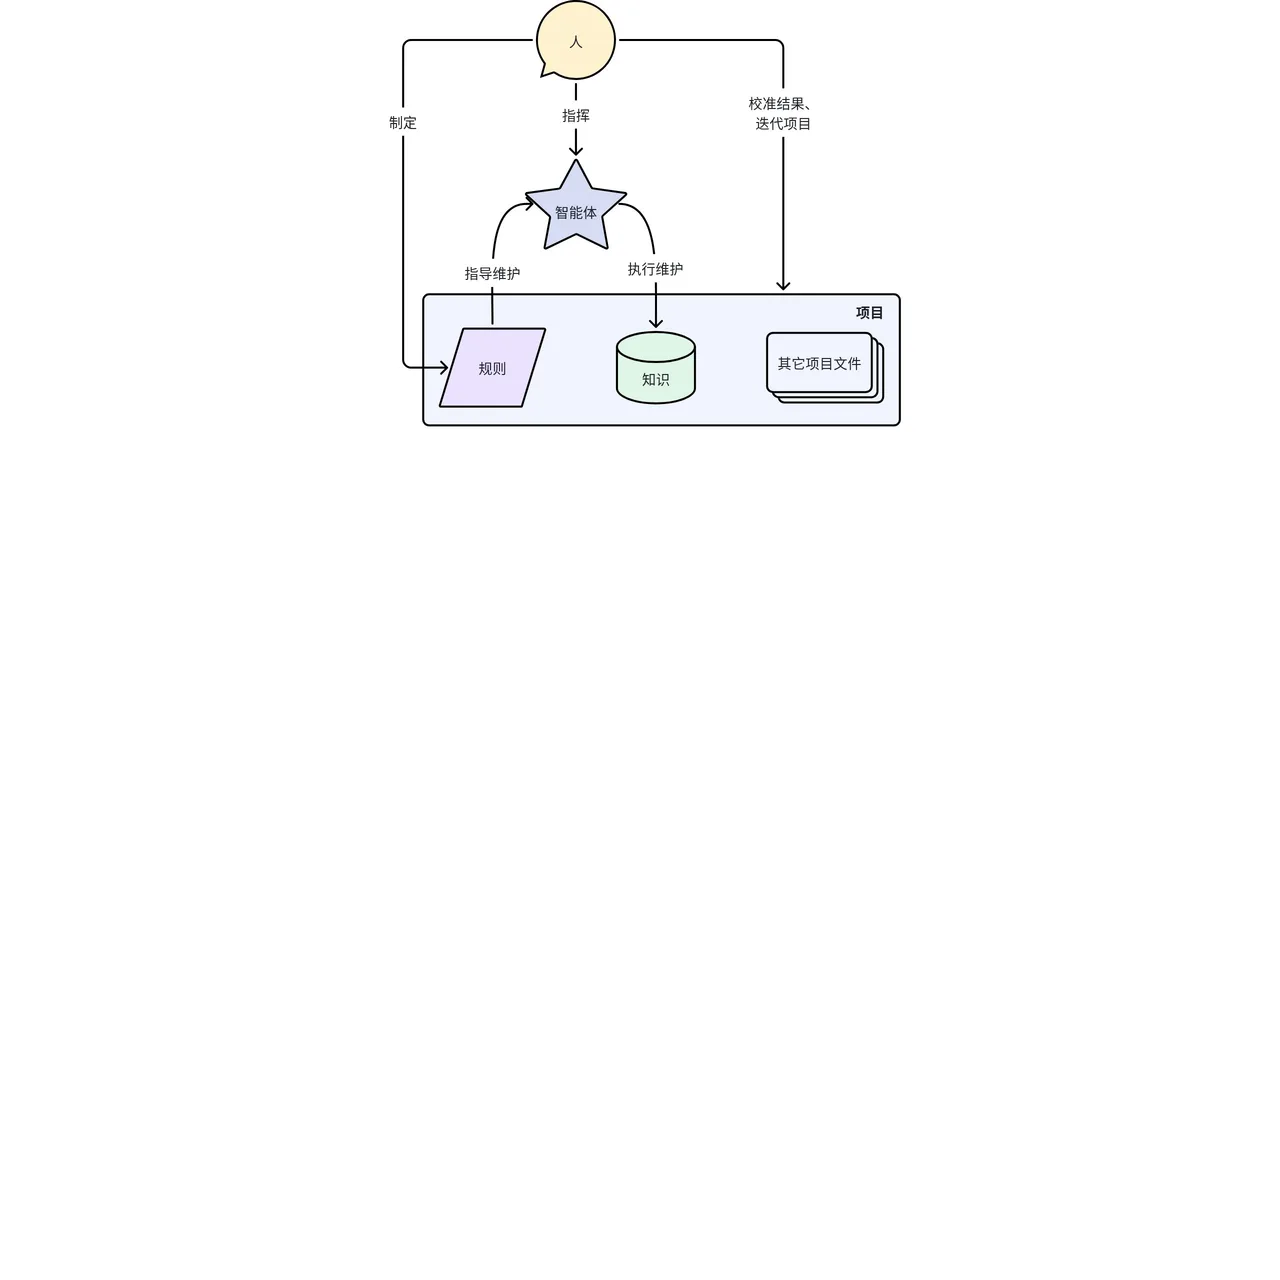
为持续业务保留一个项目空间。在计算机上表现为一个目录——我们提供给 Agent 该目录的权限、向该该目录投放知识,Agent 被授权在这个目录下阅读里面的知识、创建新的文件。
两个简单的开始:项目启动模版 + 通用项目规则 = 新聊天的第一条信息
- 项目启动模版是一个半结构化的表单。
- 人填写好关键信息与约束,不必一次填完,让 Agent 初步(但高信息密度、高协作价值)了解完成当前任务的必要信息。
- 四个关键词:目标、规则、边界、验收
- 通用项目规则是可直接拿来用的最佳实践提示词。
- 让 Agent 在推进任务的同时,维护当前状态、沉淀有效知识、记录错误经验,帮助后续会话保持“信息在线”。
- 无需任何修改,只需直接附在填好的启动模版后发送。只要你使用常见的智能体运行框架,你的项目将拥有自维护、自增长能力。
项目启动模板 | 通用项目规则(轻量简化版,适用于非开发工作) | 通用项目规则(较重,适用于非开发工作) |
不需一次填写完整,优先提供必要信息。Agent 会在后续交互中智能补充,也可人工填写。 | 这份项目规则只有一个目的:以文件的形式自动维护项目知识,使新的智能体在这个文件夹中能“无缝衔接”工作。核心思想:
| 规则来源见附录。 |
项目启动模板 | PROJECT_RULE.md | PROJECT_RULE.md |
原理-1
持续积累且可检索的上下文,是形成稳定业务理解的基础之一。
人接手业务,需要交接;持续做好业务,需要积累经验。与 Agent 的协作也一样:先提供必要背景,再把执行中的判断、反馈和经验留下来。这样,每次开始新会话,都能站在已有工作的基础上继续推进。
原理-2
让 Agent 利用历史协作,持续维护项目空间。前面的通用项目规则,已经包含上下文整理、状态更新、文档归档和错误沉淀等要求。这些工作可以交给 Agent 执行,人不需要亲自整理每份文档。
当项目聊天积累了一段时间的交互和资料,可以直接发:
请按[通用项目规则链接],整理本次会话和项目文件,更新项目上下文。
Agent 就会依据规则,提取有长期价值的信息,更新当前状态,整理文档入口,并将可复发的错误转化为具体规则。
先使用,再了解背后的最佳实践
最佳实践 | 通用项目规则让 Agent 自动做什么 | 人能得到什么 |
|---|---|---|
记忆外化 | 将重要事实、决策和进度从交互中沉淀到文件 | 新会话可以接着做,减少重复解释 |
入口做地图 | 维护简洁的 README,将细节放到对应文档 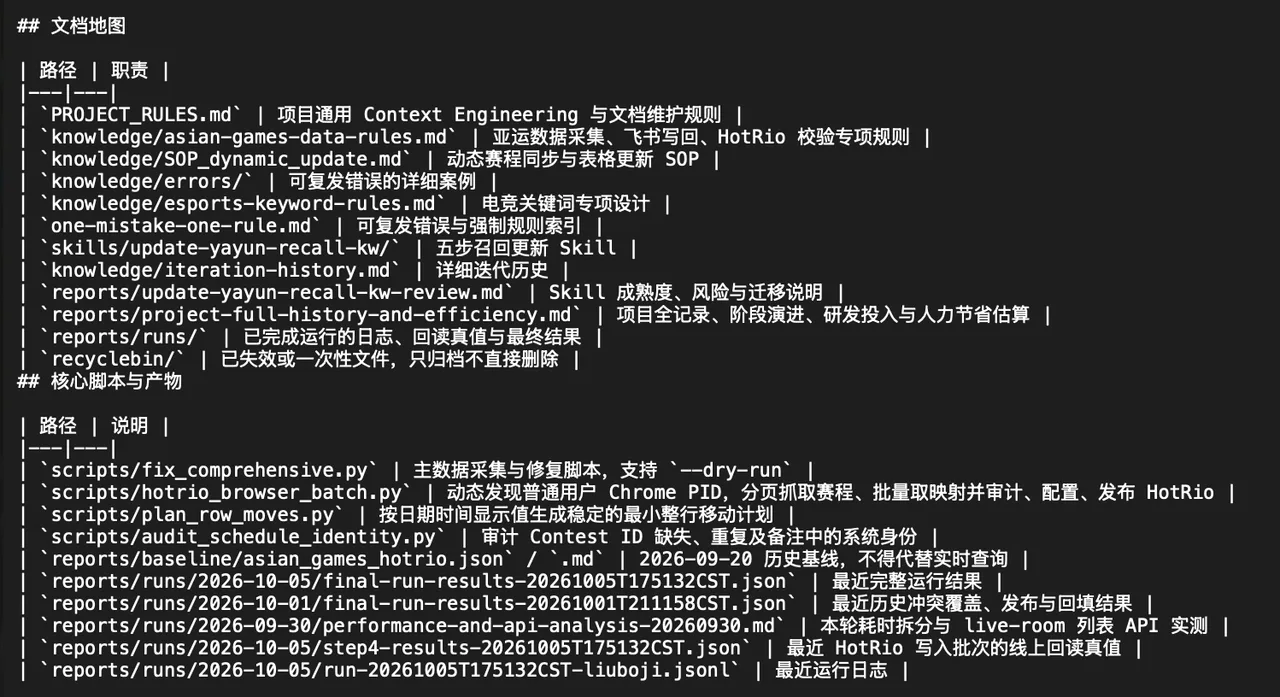 | 更快了解现状、找到资料; Agent 更高信息密度的上下文 |
按需加载 | 根据任务检索相关信息,避免每次读取全部文件 | 工作更聚焦,减少无关信息干扰 |
持续更新 | 修正过时状态、统一冲突信息、整理重复资料 | 项目反映当前情况,而非堆积历史 |
从失败中改进 | 将真实错误转为规则、示例或检查方法 | 后续任务可以复用纠错经验 |
更多「通用项目规则」的约束来源,见附录2.
项目规则本质上是上下文工程 (Context Engineering):让 AI 在当前任务中拿到需要的信息,并把值得复用的新信息留下来。
附 通用项目规则的约束来源
Context Engineering:一个Agent 运行时上下文控制系统。这是 OpenAI 与 Anthropic 当前公开实践里比较一致的方向。Anthropic 明确指出,Context Engineering 的问题是“从不断增长的信息空间中,选择哪些内容进入有限上下文”;OpenAI 的 Codex 团队则把仓库本身做成 system of record,而入口文件主要承担导航职责。
一句话设计原则:构建的不是一个越来越长的 Prompt,而是一个会自我整理、自我更新、按需暴露信息,并从真实失败中持续进化的 Agent Context System。
项目工作方法的标准闭环:Map → Retrieve → Work → Persist → Reflect → Update 。
5 个核心设计思想
- 【Anthropic】Context is scarce——上下文不是存储空间,而是注意力预算。
Anthropic:上下文越大,并不意味着效果线性提高,反而存在 context rot。因此设计目标不是“让 Agent 知道一切”,而是让正确的信息在正确的时候出现。 - 【OpenAI】Map, not manual——入口文件提供地图,而不是百科。
- 【OpenAI/Anthropic】Progressive disclosure——知识分层,按需展开。
L0 Rules: 项目通用规则 / one-mistake-one-rule
↓
L1 Map & State: README.md
↓
L2 Knowledge: knowledge / reports / scripts
↓
L3 Task Context: 当前任务真正需要的局部信息 - 【OpenAI/Anthropic】Externalized memory——长期项目状态必须外化。
不能期待一次会话的上下文承担长期记忆。Anthropic 的 long-running agent 实验专门维护 progress 文件;OpenAI 也把 repository knowledge 作为 system of record。换句话说,项目文件不是附属文档,而是 Agent 的长期工作记忆。 - 【Anthropic】Failure-driven evolution——规则从真实错误中增长,而不是设法预先考虑所有可能,更不是从想象中增长。
Anthropic 公开建议就是:从 minimal prompt 开始,根据实际 failure modes 增加规则和 canonical examples,不要把所有边界条件提前写进 prompt。
形成项目规则的所有来源
| 归类 | 规则设计 | 你的规则解决什么问题 | 厂商公开实践依据 |
|---|---|---|---|
| 信息密度 | README ≈100 行,只做地图 | 防止项目主 Prompt 越写越长,最终所有信息都变成“重要信息” | OpenAI Codex 团队明确表示“大型 AGENTS.md”会挤压真正任务上下文,并采用约 100 行的入口文件,将完整知识放到结构化 docs 中。(OpenAI) |
| README = Map + State + Routing | 新 Agent 不必重新理解整个项目 | OpenAI 将 AGENTS.md 定义为 table of contents,而非 encyclopedia,并强调 repository knowledge 为 system of record。(OpenAI) | |
| Progressive Disclosure 渐进式披露 | 避免一次加载全部知识造成 context pollution | OpenAI 明确将“小而稳定入口 → 再寻找深入资料”称为 progressive disclosure。(OpenAI) | |
| 只加载当前任务需要的信息 | 降低上下文长度,提高注意力集中程度 | Anthropic 指出 Context 是有限资源并存在 diminishing returns,最佳上下文是能够实现目标的“smallest possible set of high-signal tokens”。(Anthropic) | |
| Just-in-time 检索 | 项目越大越不能静态塞入 Prompt | Anthropic 明确指出 Agent 系统正从 pre-inference retrieval 转向结合 just-in-time context 的方式。(Anthropic) | |
| 知识不能只存在聊天中 | 防止会话切换后丢失关键决策 | OpenAI 指出,如果知识只存在 Slack、Google Docs 或人的脑中,而 Agent 无法访问,对 Agent 而言实际上等同于不存在;因此应把知识变成可发现、版本化的项目资产。(OpenAI) | |
| 每日 Iteration 只保留重要变化 | 保留项目连续性,又不成为完整操作日志 | Anthropic 长周期 Agent 实践要求每个 session 留下 structured progress updates,使下一窗口不用重新猜测已经发生的工作。(Anthropic) | |
| 持久化维护 | 文档自动合并、更新、归档 | 防止知识库只增不减 | OpenAI Codex 项目使用自动 doc-gardening agent 定期扫描 stale / obsolete documentation 并进行修复。(OpenAI) |
| 优先更新已有文件,而不是不断新建 | 防止 knowledge/ 最终变成 Markdown 垃圾场 | OpenAI 指出单体文档会“rot”,因此采用结构化知识库、索引和持续 doc gardening;这条属于我根据该原则做的工程化落地。(OpenAI) | |
| 项目文件作为 Source of Truth | 防止同一事实多个版本 | OpenAI 明确把 repository knowledge 作为 system of record,并强调版本化、交叉链接和 freshness。(OpenAI) | |
| 事件驱动更新,而非每轮记日志 | 防止 Agent 自动维护变成“自动制造噪音” | Anthropic 的核心原则是高信号最小上下文;OpenAI 也强调 knowledge base 应保证 freshness,而不是保留所有过程。(Anthropic) | |
| 工作结束留下 clean / resumable state | 下一 Agent 可以直接接着做 | Anthropic 要求每轮 session 留下 clean state、progress summary 和结构化状态,避免下一轮重新猜测。(Anthropic) | |
| 新状态覆盖旧状态 | 避免上下文中同时存在多个互相矛盾的当前版本 | OpenAI 指出 monolithic knowledge 最大问题之一就是 stale rules,同时专门使用 doc-gardening agent 发现 stale / obsolete documentation。(OpenAI) | |
| 区分事实 / 决策 / 假设 / 待确认 | 防止 Agent 将自己的推断写成长期事实 | OpenAI 强调 agent instructions 应处理 ambiguity、edge cases,并在失败情况下能够 halt / transfer control;Anthropic 同样强调 prompt 必须清晰,但不能硬编码所有逻辑。这四态分类是对此的工程化实现。(OpenAI) | |
| recyclebin 而非直接删除 | 保留可追溯性与人工恢复能力 | 厂商没有规定必须存在 recyclebin;这是你的工程约束。它与 OpenAI 强调 versioned artifacts、历史可追溯的原则一致,但属于你的设计,而不是厂商原话。(OpenAI) | |
| one-mistake-one-rule | Agent 根据真实失败持续改善 | Anthropic 明确建议先使用最小 Prompt 测试,然后根据观察到的 failure modes 再增加明确规则和示例,而非预先塞入所有边界情况。(Anthropic) | |
| Prompt 结构化分节 | Agent 更容易理解各规则职责 | Anthropic 推荐使用 Markdown headings 或 XML tags 把 background、instructions、tool guidance、output description 等明确分区。(Anthropic) | |
| 人机协作 | 允许 Agent 主动询问信息 | 长期项目中的真实状态可能变化 | OpenAI 对 Agent 的定义本身包含根据 workflow state 动态决策、在失败或信息不足时将控制权交还用户。(OpenAI) |
| 增量推进,而不是 one-shot | 长项目最常见问题是 Agent 一次试图完成过多工作 | Anthropic 在长周期 Agent 实验中明确发现 one-shot 是主要失败模式,并要求每次只推进一个明确 feature,持续 incremental progress。(Anthropic) | |
| 动作必须具体 | “主动维护”“注意更新”这种抽象表达执行率低 | OpenAI 的 agent instructions 指南明确建议把复杂资料拆成清晰步骤,并让每个步骤对应一个具体 action 或 output。(OpenAI) | |
| 先单 Agent + 文件体系,不先搞复杂多 Agent | 控制整个 Context 系统复杂度 | OpenAI 建议先最大化 single-agent 能力,仅在复杂度真正需要时再拆 multi-agent。(OpenAI) | |
| 规则本身也应迭代 | Context Engineering 不是一次性写 Prompt | Anthropic 将 Context Engineering 描述为持续、循环的 context curation;OpenAI 也通过持续 doc-gardening 维护知识结构。(Anthropic) | |
| 低风险假设继续,高风险问题确认 | 避免 Agent 要么什么都问,要么什么都猜 | Anthropic 建议 Prompt 处于“Goldilocks zone”:既不能硬编码所有逻辑,也不能过度模糊,需要提供 strong heuristics。(Anthropic) | |
| 不要预先穷举所有错误 | 防止规则越来越复杂、越来越脆弱 | Anthropic 特别反对将大量 edge cases 塞入 Prompt,建议选择少量 canonical examples,并从实际 failure modes 中逐步改善。(Anthropic) |
2.2 🚏留流程
/ 把高频工作场景固化成SOP/SKILLS
概念辨析 / 大模型(LLMs)、工作流(workflow)、智能体(Agent)、技能(SKILLS)
- 大模型:具有世界知识,无状态,回复通用回答。无状态 = 缺少业务上下文和默会知识。
懂体育、会分析的同事,能理解比赛信息、生成关键词,但需要告诉他具体业务工作。 - 工作流:预设流程。提前安排的五步:同步赛程、准备配置队列、生成关键词、自动化配置、回填验收。
只有这五步的定义还不够,智能体无法符合预期地执行。 - 智能体:有“大脑”(LLM)、可根据情况选择下一步的软件体。你给他需求、验收内容和边界,他根据情况决定下一步,在授权范围内调用工具、推进任务。
能有边界地具体执行:借助大模型思考,调用表格、浏览器和脚本;遇到失败,按规则重试、换路径,或退出等待人处理;约束权力边界,不做越界的事。 - SKILLS:专项操作手册和工具包。
写清怎么去重、关键词生成规则、怎么算发布成功、怎么算一个任务结束...- eg. 如何确认菜单?向顾客发送菜单,经过多轮CRUD和最终确认后得到确认菜单。
- eg. 如何服务?查询服务手册(md文档链接),里面写有:打招呼欢迎、引导入座、上湿巾/倒茶、点菜、前厅后厨协作(api调用、同步、工单系统...)、...、结账(结账流程)...
它们如何协同? / 大模型、工作流、智能体、技能
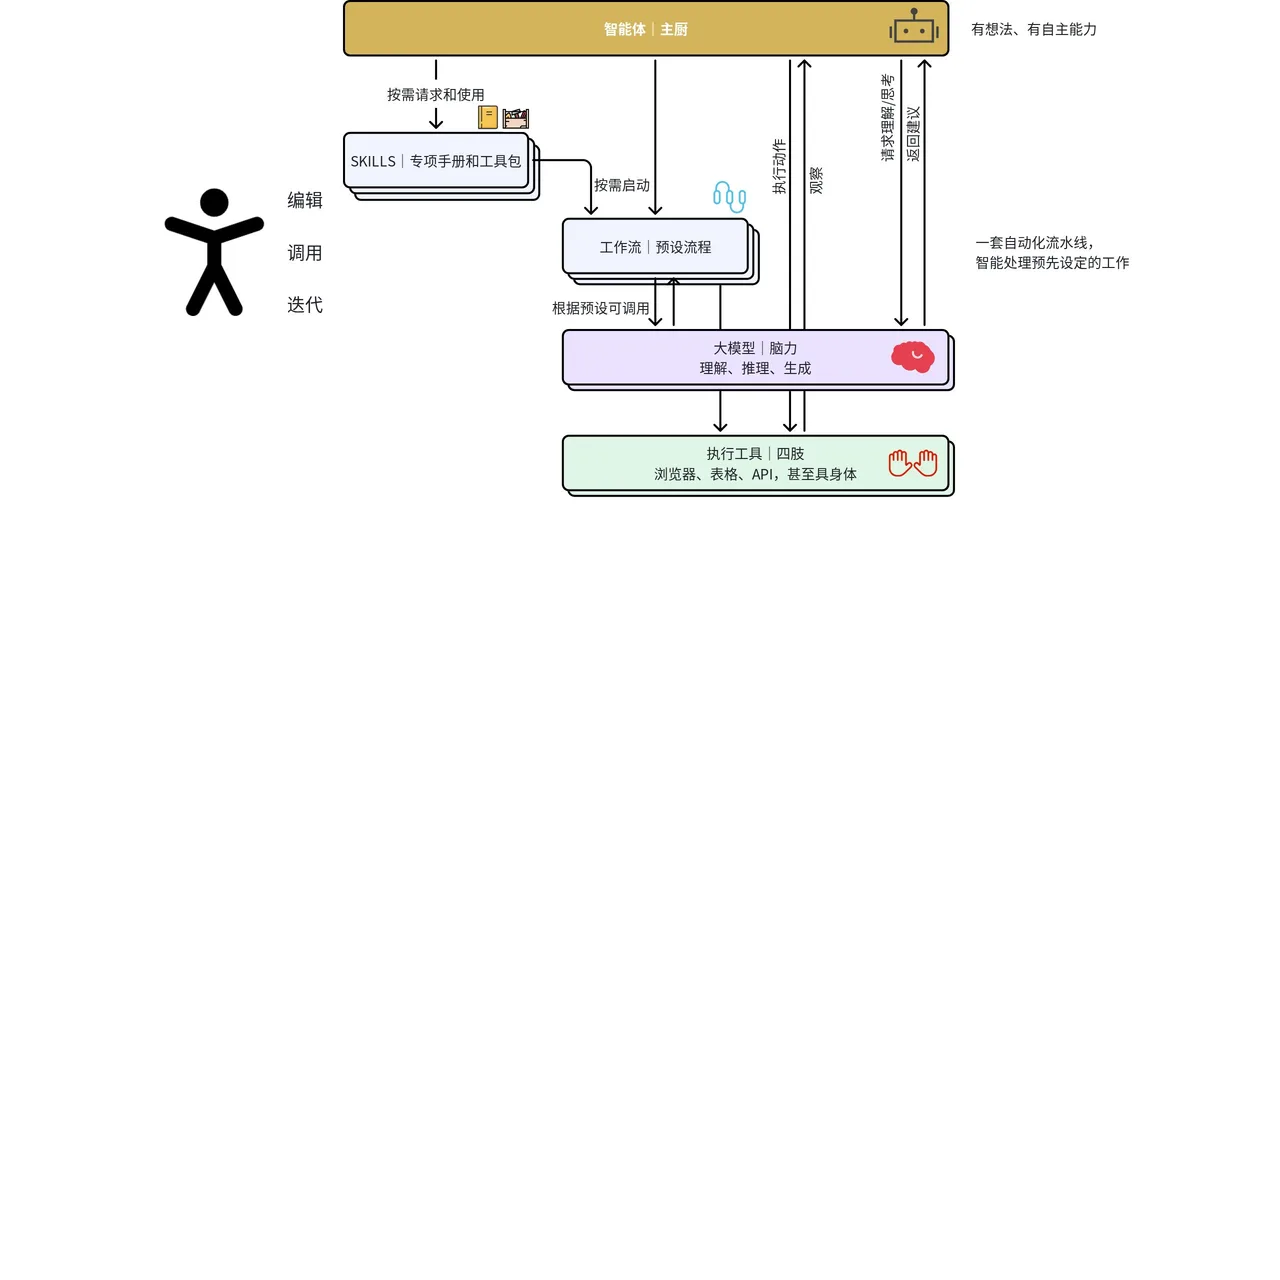
形成 SKILLS / 一个复杂、但可以交给智能体的任务,如何形成稳定可用的 SOP / SKILLS?
- 按人工完成的流程,定义关键原子步骤
- 跑通关键/复杂的一步
- 串联所有流程,跑通,粗糙地开始
- 持续迭代和优化
2.3 🙅留错误
/ 把错误转化为持久化的后续约束
通过项目规则 one-mistake-one-rule.md 自动维护。
发现可能复发的错误,修正当前结果后,再留下四项信息:错在哪里、正确规则、适用范围、怎样检查。
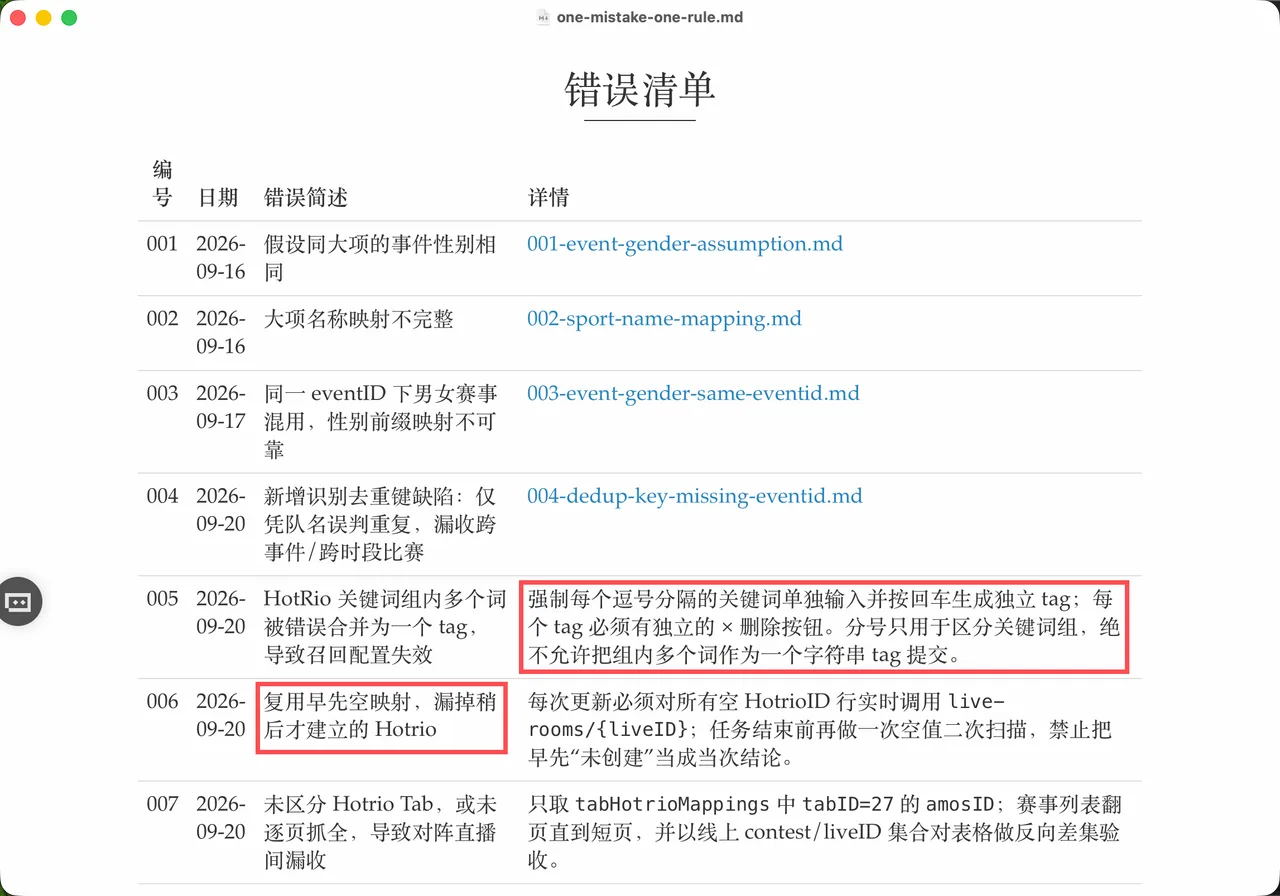
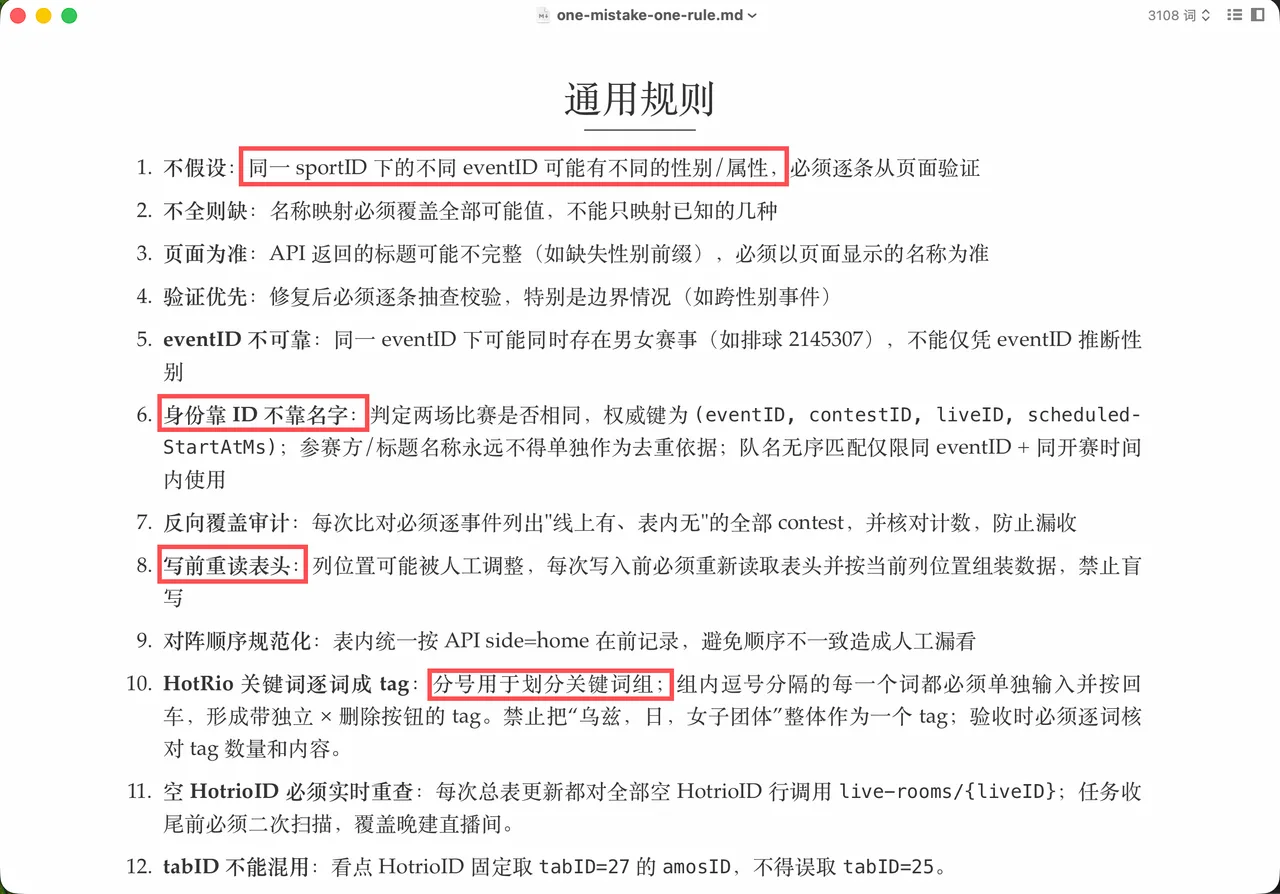
附 one-mistake-one-rule.md
3 真实场景应用:亚运召回例子
3.1 任务拆解
/ 按人工完成的流程,定义关键原子步骤
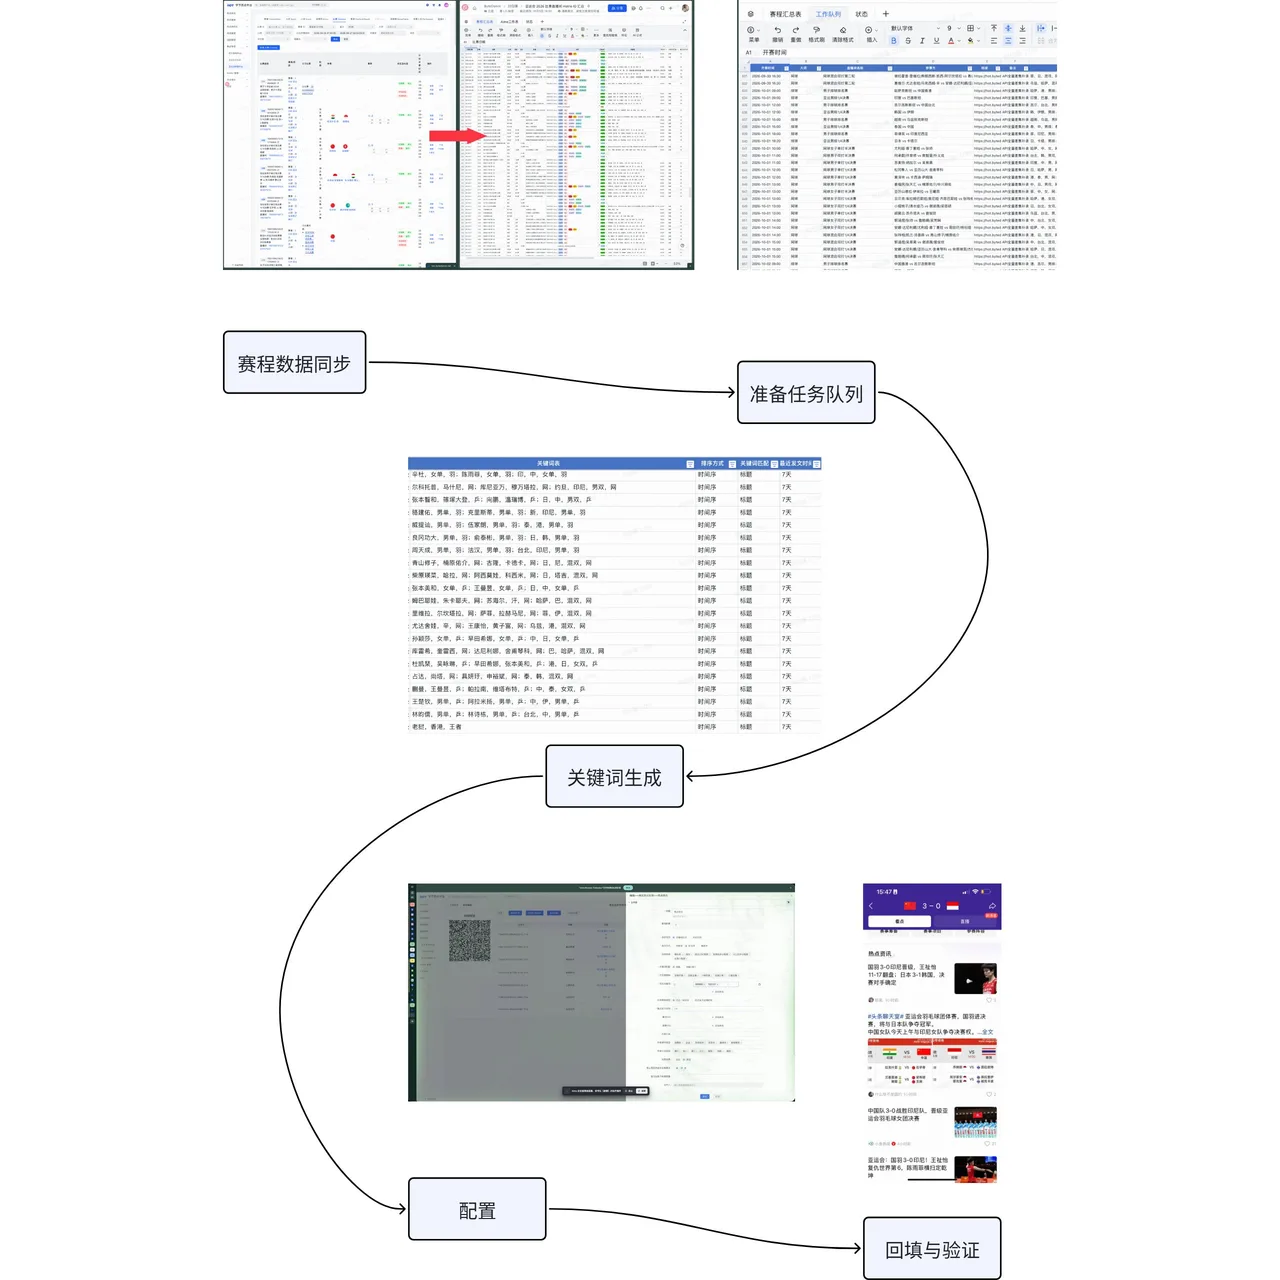
从业务要求看,完成一次召回配置,需要走过这条链路:同步最新赛程 → 筛出待配置记录 → 生成关键词 → 人工核验与微调→ 配置并发布 → 人工检查 → 回读线上结果、回填总表。
其中既有重复动作,也有业务判断。每一条配置需要准确的id、参赛方、比赛名称、项目、时间信息,有时需要web_search补齐原始登记的信息缺失。典型的信息缺失有:比赛性别、(中台未更新时)比赛对阵双方人名。
抽象概括成五步:同步赛程、准备任务队列、生成关键词、配置与发布、回填与验证。
以亚运图文直播召回任务为例,我定义为以下五步:
赛程数据同步
⬇️
准备任务队列
⬇️
关键词生成
⬇️
配置
⬇️
回填与验证
3.2 从零构建 / 如何从零得到一个可自动化工作的智能体?
——从「帮我补表」,到跑通一条配置,到「/update-yayun-recall-kw」
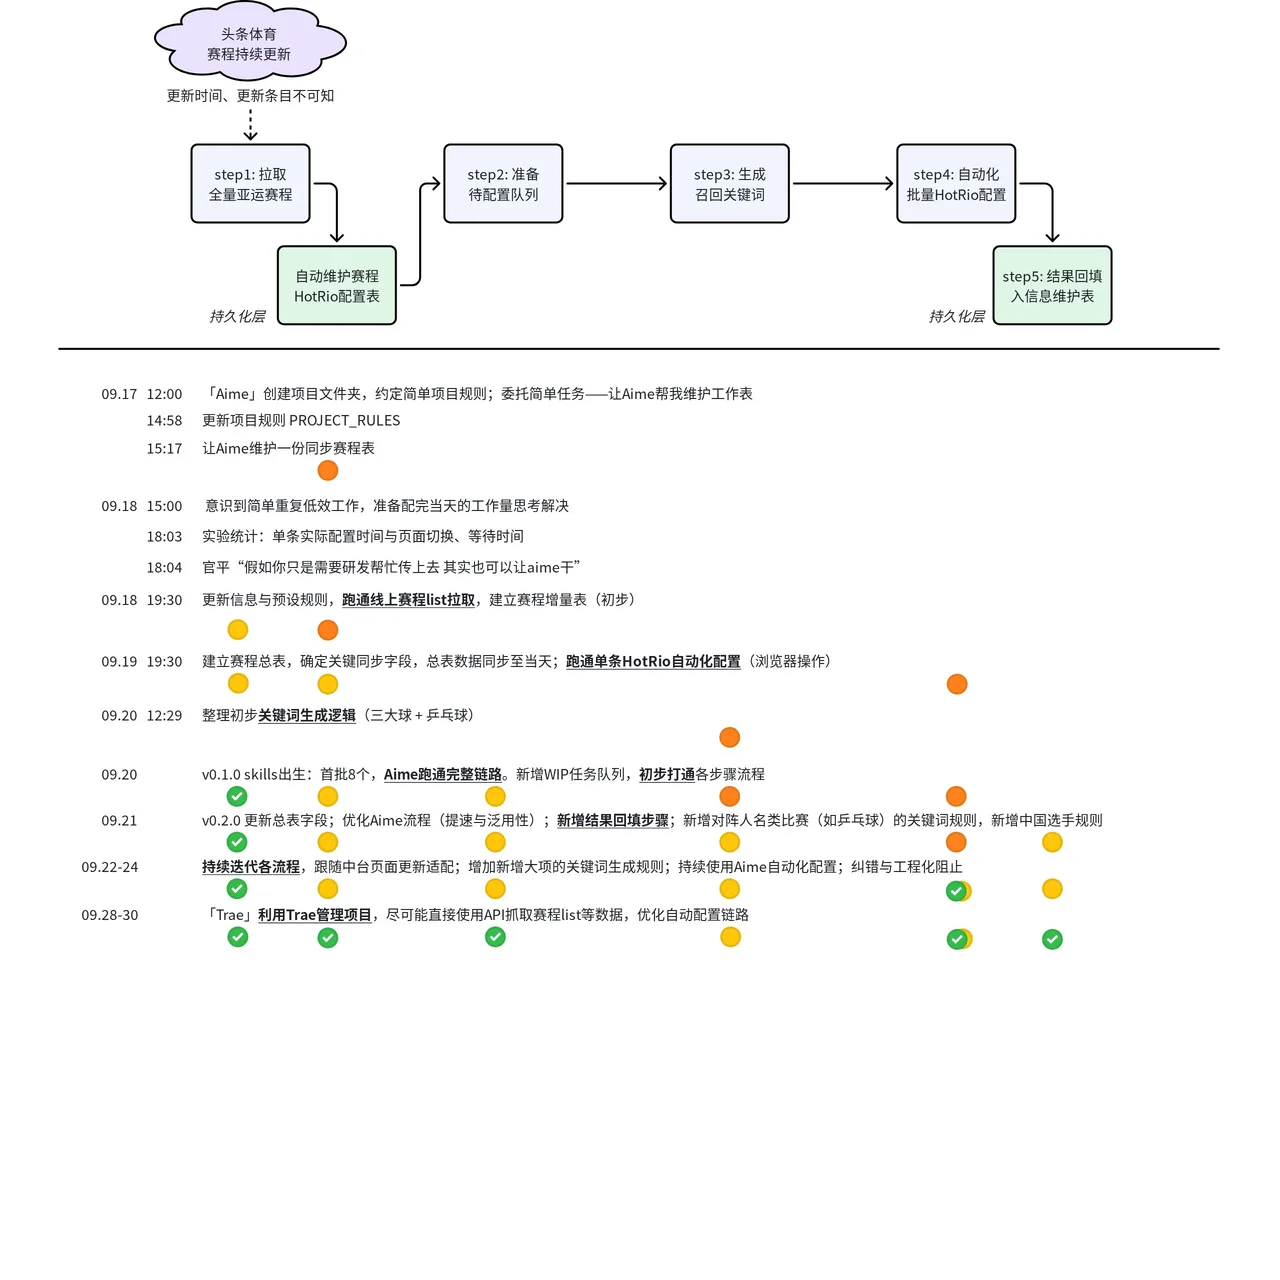
update-yayun-recall-kw并不是人先写好完整方案,再让 AI 照着执行。它从一句“帮我补齐赛程表”开始,在实际任务中逐步搭建:人提出目标、核对结果、指出问题,AI 编写脚本和操作文档;发现错误后,再一起修改规则、重新验证。
Preview / 最终SKILLS目录结构
亚运图文直播召回/                            # 项目根目录
├── README.md                              # 项目说明、使用入口与目录导航
├── PROJECT_RULES.md                       # 项目级规则、约束与操作规范
├── one-mistake-one-rule.md                # 错误复盘:每个问题沉淀一条规则
├── knowledge/                             # 项目知识库与方法沉淀
│   ├── SOP_dynamic_update.md              # 动态更新流程说明
│   ├── esports-keyword-rules.md           # 电竞项目关键词生成与校验规则
│   └── iteration-history.md               # 项目迭代过程与关键变化记录
├── skills/                                # 可复用 Skill 集合
│   └── update-yayun-recall-kw/             # 亚运召回更新 Skill
│       ├── SKILL.md                       # Skill 的触发条件、流程与使用说明
│       ├── references/                     # Skill 依赖的详细参考文档
│       ├── scripts/                        # Skill 使用的执行脚本
│       └── tests/                          # Skill 脚本的自动化测试
├── reports/                               # 运行结果、分析报告与验证记录
│   ├── baseline/                           # 基线数据与初始状态
│   ├── runs/YYYY-MM-DD/                    # 按运行日期归档的执行产物
│   ├── project-full-history-and-efficiency.md # 项目完整历史与效率分析
│   └── update-yayun-recall-kw-review.md    # Skill 使用效果与复盘报告
└── recyclebin/                            # 暂存的旧文件与历史版本
    ├── legacy-root-files/                  # 原根目录文件的历史版本
└── legacy-skill-scripts/ # 旧版 Skill 脚本留背景,给智能体一个施展拳脚的空间。让智能体拥有业务视角和长期记忆,从重复和烦躁中彻底解脱。
根据实际体验,约 95% 的代码和文档编写由 Agent 编写与自动维护。人的主要投入在两方面:
- 提供通用知识:通用 Agent 项目规则约束;
- 提供业务知识:业务判断、抽查验收和纠偏;定义权限边界、可信、成功态、异常与终止。
SKILLS诞生的各阶段:
| 阶段 | 人如何指导和验收 | AI 完成什么 | 沉淀下来的能力 |
|---|---|---|---|
| 先帮忙补表 | 指定目标表、需要补的字段,抽查结果 | 取数、整理数据、编写补表脚本 | 写前重读表头、按字段名定位、写后回读 |
| 先跑通一条配置 | 明确关键词、参数和发布成功的标准 | 操作 HotRio,排查输入、保存和发布问题 | 单条配置闭环,验收通过才回写状态 |
| 扩展到批量取数 | 指出漏赛程、同名比赛误合并、晚建直播间等问题 | 修改采集、分页、去重和重查逻辑 | 系统 ID 判重、完整性检查、空映射复扫 |
| 扩展到批量配置 | 检查批量结果,指出“保存成功但未发布”等误判 | 增加逐条验收、失败记录和恢复机制 | 批次隔离、发布回读、幂等恢复 |
| 整理成 Skill | 确定默认处理范围、权限边界和验收口径 | 整理入口说明、SOP、脚本和运行记录 | 可重复调用的五步流程:同步、迁移、关键词、配置、回填验收 |
「跑通 关键/复杂 的一步」
攻破困难节点。上述流程中,瓶颈有两个:赛程数据同步和关键词配置。
- 赛程数据同步:需打通一条链路——赛程数据抓取 -> 飞书列表读取 -> 数据处理与判等。需要人找到抓取的可行链路,提供飞书权限,确定列表字段定义以及判等逻辑。
- 关键词配置:需探索 Aime 或 Trae 等 Agent Harness 工具能否/如何实现自动化配置,涉及鉴权、前台自动化或后台提交。
可行的路径有 computer-use、browser-use、Tool Use、API、脚本与CLI、MCP、skills,以及前面若干工具的混合方式。
明确瓶颈后,人工 或 人xAgent合作 跑通某一条智能体可执行的路线,然后让智能体自己记录可复现的“说明书” => skills的雏形。
「串联所有流程,跑通,粗糙地开始」
关键节点解决后,剩下的就是打通整个流程。我的理念是先盖草屋再盖城堡,因此搭建期不追求一步做到完美,而是先跑通最小闭环。
- 「准备任务队列」的核心能力是飞书表格操作,在「赛程数据同步」步骤中已跑通,只剩判等与迁移,先用赛程id判等、最小介入让智能体做数据填充
- 「关键词生成」迅速写好关键词召回逻辑与若干条基本规则(保准尽召),保证上线不出错
- 「回填与验证」非MVP必须,丢弃
- 规定最朴素的串行流程——前一节点关闭自动进入下一节点
- 直接开始首次测试
Aime 正在
3.3 持续迭代和优化
流程跑通只是起点。真正的迭代,发生在流程遇到真实问题之后:从局部修复变成全量审计,从接口结果变成多源取证,从“执行完成”变成“回读证明”,从一次性错误变成长期规则,再从全量重跑变成增量探测和断点恢复。
迭代的目标是扩大系统泛用性与逐渐收敛行为边界。让系统在数据变化、页面变化和部分失败的情况下,仍然知道哪些可以继续、哪些必须停下来交给人判断。
三条主线:
- 浏览器操作与API重新分工。早期靠浏览器完成逐页操作、点选和录入等80%以上工作;后续调整为仅负责登录态、关键页面核验
- 加速时间瓶颈的步骤、流程精简。不是让AI点的更快,而是减少不必要操作:不重复写、不重复发、失败范围重试
- 复盘闭环到未来收益——优化与杜绝。下一轮产生实际收益、更高可用性。
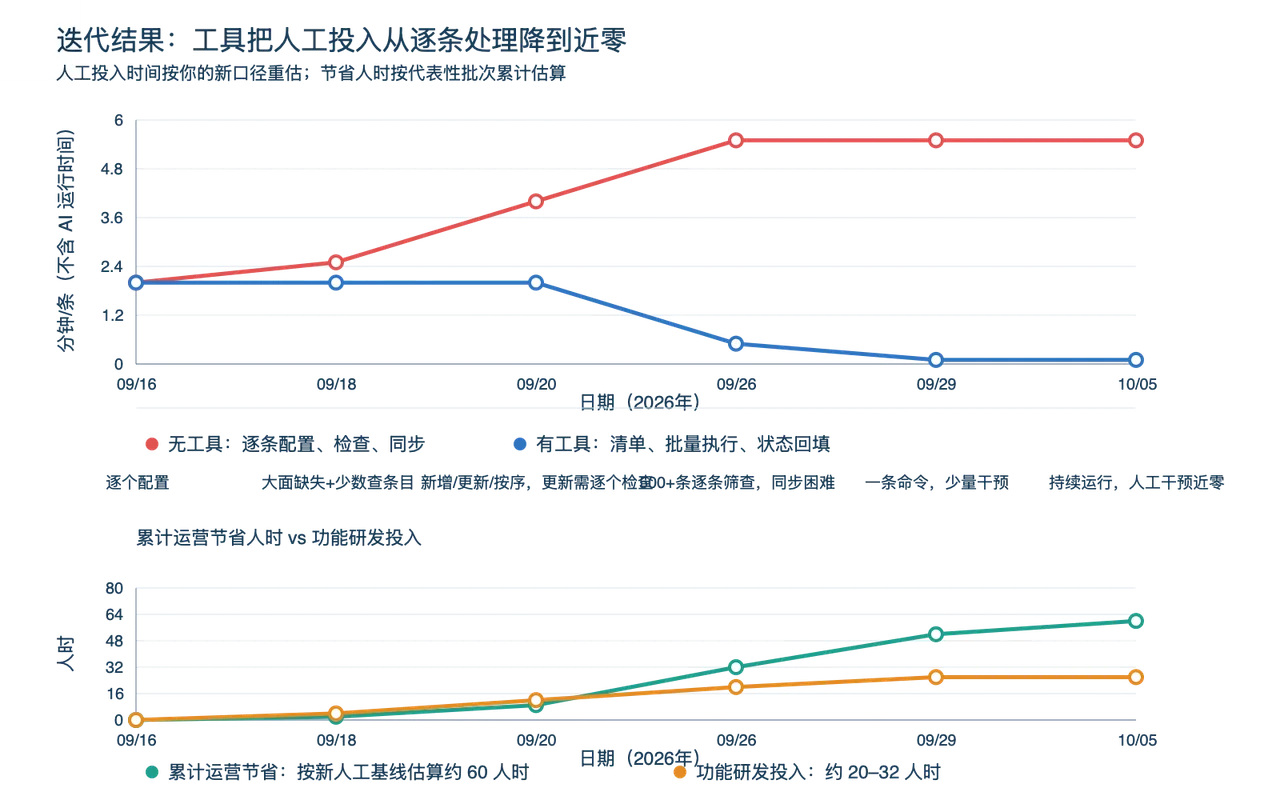
迭代收益
- 无工具:09/16 的 1–3 分钟,逐步上升到 09/26 及以后 5 分钟以上。
- 有工具:从 1–3 分钟逐步降到 0–0.2 分钟。
- 累计运营节省按新基线重算,约 60 人时。
- 功能研发投入仍按功能拆分估算为 20–32 人时。
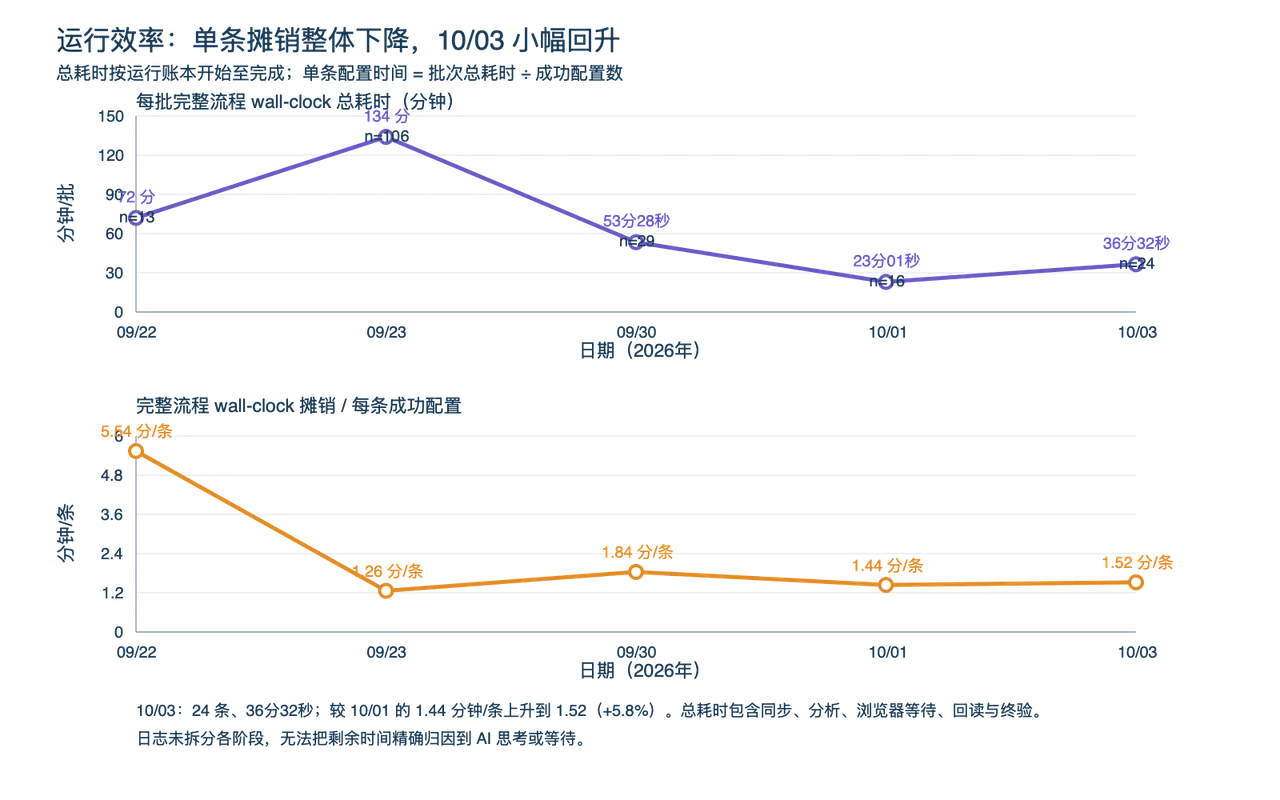
运行效率
- 自动化单条配置平均时间从5分钟+/条降至约1.5分钟/条
附-迭代内容表
| 迭代方向 | 遇到问题 | 迭代内容 | 效果 | |
|---|---|---|---|---|
| 操作API化 | 浏览器操作改为 API 批量取数 | 逐条打开浏览器页面,速度慢,也容易受到页面加载和登录状态影响 | 用 API 批量获取赛事、时间、状态、参赛方和 liveID;浏览器只负责登录态、页面核验和最终配置 | 一次可以读取 25 页、1202 条赛事;全量映射得到 871 条 HotRio,331 条确认无映射,0 条请求失败 |
| API 与浏览器分工 | API 适合批量读取,但无法完全证明页面上的发布状态;浏览器适合核验,但不适合大批量读取 | 结构化数据交给 API,关键名称、页面区块和发布状态交给浏览器;两边结果交叉核对 | GIP 管理页不可用时,仍能用 API + 浏览器页面完成流程;13 条配置全部通过线上发布验收 | |
| 流程优化 | 从全量写入改为增量写入 | 每轮都重写整张表,容易覆盖人工修改,也浪费时间 | 每轮先建立线上和表格快照,只计算真正发生变化的单元格,再做最小写入 | 一轮 1202 条线上赛事只更新 8 行、19 个单元格;队列内容保持不变,避免无变化写入 |
| 从“跑完”改为“先审计再决定是否执行” | 没有新增任务时,仍可能重复生成关键词、保存配置或发布 | 先判断新增、变化、待处理任务和异常;如果执行集合为空,明确生成空批次,不触发写操作 | 1237 条主表、679 条队列完成全量核验,未发布数为 0,且本轮没有无意义的线上写入 | |
| 解决浏览器实例定位问题 | Chrome 重启后 PID 会变化;电脑上同时存在多个 Chrome,固定 PID 或只看应用名可能选错实例 | 改成每次运行动态发现普通用户 Chrome;排除临时 profile、远程调试实例和隔离浏览器,并用目标标签和无副作用探针确认 | Chrome 重启后仍能重新定位;不再依赖旧 PID;双 Chrome 环境下也能选择正确实例 | |
| 解决浏览器桥接的大批量传输问题 | 1202 条结果一次通过 Apple Event 回传,超过稳定传输大小,导致任务看起来超时 | 改为先取小状态,再按 32KB 分块回收结果;浏览器任务和结果读取分离 | 全量映射最终稳定回收;1202 条中 871 条有 HotRio、331 条无映射、0 条失败 | |
| 从一次失败重跑,改为按失败类型重试 | 84 条记录出现 Failed to fetch,不能直接判断为没有 HotRio | 将结果分为 FOUND、NOT_FOUND、FAILED;只重试失败批次,重试前补齐原始日期等必要字段 | 84 条重试后得到 62 条 FOUND、22 条 NOT_FOUND、0 条 ERROR;未知结果清零 | |
| 修复数据解析和身份定位 | 飞书 CSV 中单元格有换行,按物理行解析会错位;部分历史记录没有 Contest ID | 改用逻辑行解析;身份定位按“Contest ID → HotRio ID → 名称与日期”逐级回退 | 修复了闭幕式时间从 17:00 到 16:00 的变更,并补回缺失身份;11 行、27 个单元格完成准确更新 | |
| 自进化 | 把 AI 复盘变成代码和 SOP 的更新 | 每次异常都靠人重新解释,问题容易重复出现 | AI 根据运行日志定位根因,再同步修改脚本、SOP、规则和回归检查 | 例如把“响应结构变化误判为空映射”“旧 PID 固定写入”“大批量结果一次回传”等问题,转成长期规则 |
| 泛用性 | 让 AI 参与“是否应该继续”的判断 | 页面异常时,盲目重试可能造成重复写入或误发布 | AI 先判断是接口失败、页面未初始化、目标区块不存在,还是浏览器桥接阻塞;不确定时先停止写入 | 遇到 74 个页面没有目标区块时,只成功配置 1 条,其余安全保持“待输入”,没有误改状态 |
| 历史记录 | 加入运行账本和证据归档 | 任务完成后很难知道改了什么、为什么改、是否真的生效 | 每轮保存基线、revision、changeset、失败分类、回读结果和最终报告 | 后续可以比较两轮差异,确认本轮是否真的写入;无变化运行也有完整证据链 |
项目级关键文件
README.md | PROJECT_RULES.md | one-mistake-one-rule.md |
业务知识的map。 README 最常用于开源项目,用来介绍项目、安装运行方法、使用示例,以及如何参与开发。 随着 AI 智能体参与工作,README 也称为 AI 理解项目的入口,把人的经验变成可读取的项目知识。 限制行数:100行。
| 通用知识。 参考 OpenAI / Anthropic 官方分享与开发者最佳实践,非重代码/开发项目可通用的项目规则。 本质是 Context Engineering(上下文工程) 、项目管理,以及大模型注意力管理。为大模型提供复杂、有持续维护需求的工程方法论。 | 业务知识。 来自 Mitchell Hashimoto,一位美国软件工程师和创业者,Harness Engineering 概念提出者,HashiCorp 联合创始人。 由 PROJECT_RULES.md 衍生。(通用工程框架实际发挥作用的可视化呈现;) 给智能体犯的错提供长期记忆能力。为什么是“提供”?不持久化地记录错误,宝贵的人工信号大概率淹没在历史对话记录里,下一次还犯。 消除人的烦躁焦虑感:下一次能不能避免不知道,至少它被确确实实地落盘了(体感上绝对能降低同一错误再犯的经历;能让你的项目在复杂度增加时,出现管理、推进困难的时间推迟很多) (为模型)提供深度思考和探索解决方案的原料:(人的)长期记忆是深度思考的基础;降低同类错误再次发生的机会。 |
README.md | PROJECT_RULES.md | one-mistake-one-rule.md |
skills 内关键文件
SKILL.md | project-config.md | keyword-generation.md | hotrio-execution-sop.md |
自顶向下:任务描述、流程简述、各步骤操作简述 更像一个「地图/索引」,不直接展开具体细节,而是提供详细说明的文件路径。 由Agent自动维护。 | 项目配置。包含飞书表格、本地关键文档等重要资产的链接,表格的规则、列名与列名定义,漂移处理等。 由Agent自动维护。 | 关键词生成规则:字段含义与规则;从比赛信息生成关键词,必要信息主动联网搜索补全 人与Agent协作维护 | hotrio编辑页面的操作SOP。 由Agent自动维护。 |
SKILL.md | project-config.md | keyword-generation.md | hotrio-execution-sop.md |
3.4 实际运行
流程与错误,让工作流能端到端执行,让智能体在下一次面对分叉路口时选择正确的途径,提高系统的稳定性和泛用性。
Review / 实际skills的目录结构-更新亚运召回关键词
skills目录结构 / 更新亚运召回关键词
skills/update-yayun-recall-kw/
├── SKILL.md                         # 入口:适用任务、五步流程、完成条件与停止条件
├── .skillignore                     # 打包排除规则:缓存、临时数据等
├── references/                      # 按需读取的业务说明
│   ├── project-config.md            # 工作簿、目标表、表头契约及项目资料位置
│   ├── schedule-sync-sop.md         # 同步赛程:数据来源、身份去重、完整性检查
│   ├── queue-transfer-sop.md        # 迁移任务:字段映射、默认值、去重与隔离
│   ├── keyword-generation.md        # 关键词:生成提示、AND/OR 规则、证据与校验要求
│   ├── hotrio-execution-sop.md      # 配置发布:浏览器定位、参数设置、回读与验收
│   └── risk-and-recovery.md         # 异常处理、运行账本、中断恢复与风险规则
└── scripts/                         # Skill 包内的辅助代码
    ├── plan_queue_transfer.py       # 读取两表 CSV,生成去重后的追加计划
    └── validate_keywords.py         # 校验关键词格式,识别明显的宽泛召回风险
    ├── fix_comprehensive.py             # 赛程采集及整理
    ├── plan_schedule_increment.py       # 生成赛程新增、更新计划
    ├── sniff_hotrio_mappings.py          # 查询赛事与 HotRio 的映射
    ├── plan_queue_transfer.py           # 项目侧的任务迁移规划脚本
    ├── generate_match_keywords.py       # 对阵类赛事关键词生成
    ├── hotrio_browser_batch.py          # 浏览器操作入口:定位 Chrome、执行配置与回读
    ├── chrome_pid_execute.swift         # 按进程 ID 执行 Chrome 页面操作的桥接代码
    ├── plan_main_backfill.py            # 生成主表回填计划
    ├── plan_row_moves.py                # 生成表格整行排序移动计划
    ├── audit_schedule_identity.py       # 审计赛事身份与覆盖情况
    ├── test_hotrio_browser_batch.py     # 浏览器执行相关测试
    └── test_plan_row_moves.py           # 排序移动计划相关测试
执行输出 | 赛程总表 / 数据同步工作表 | 工作队列表 |
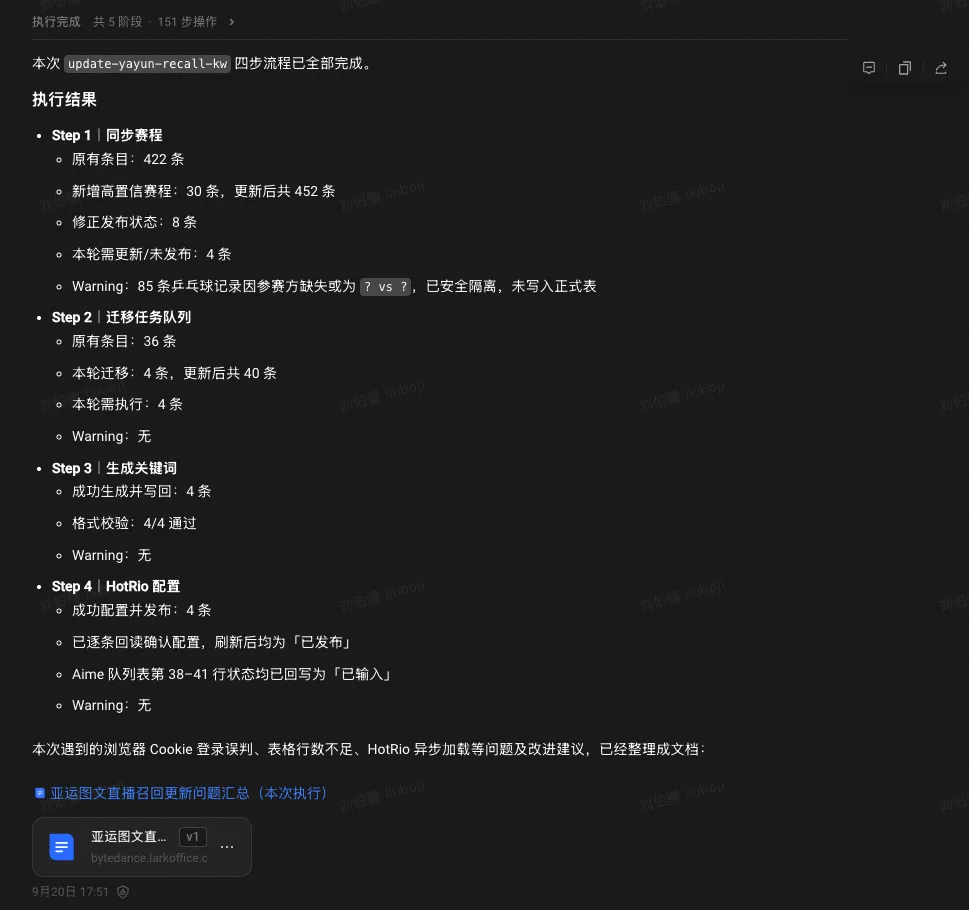 | 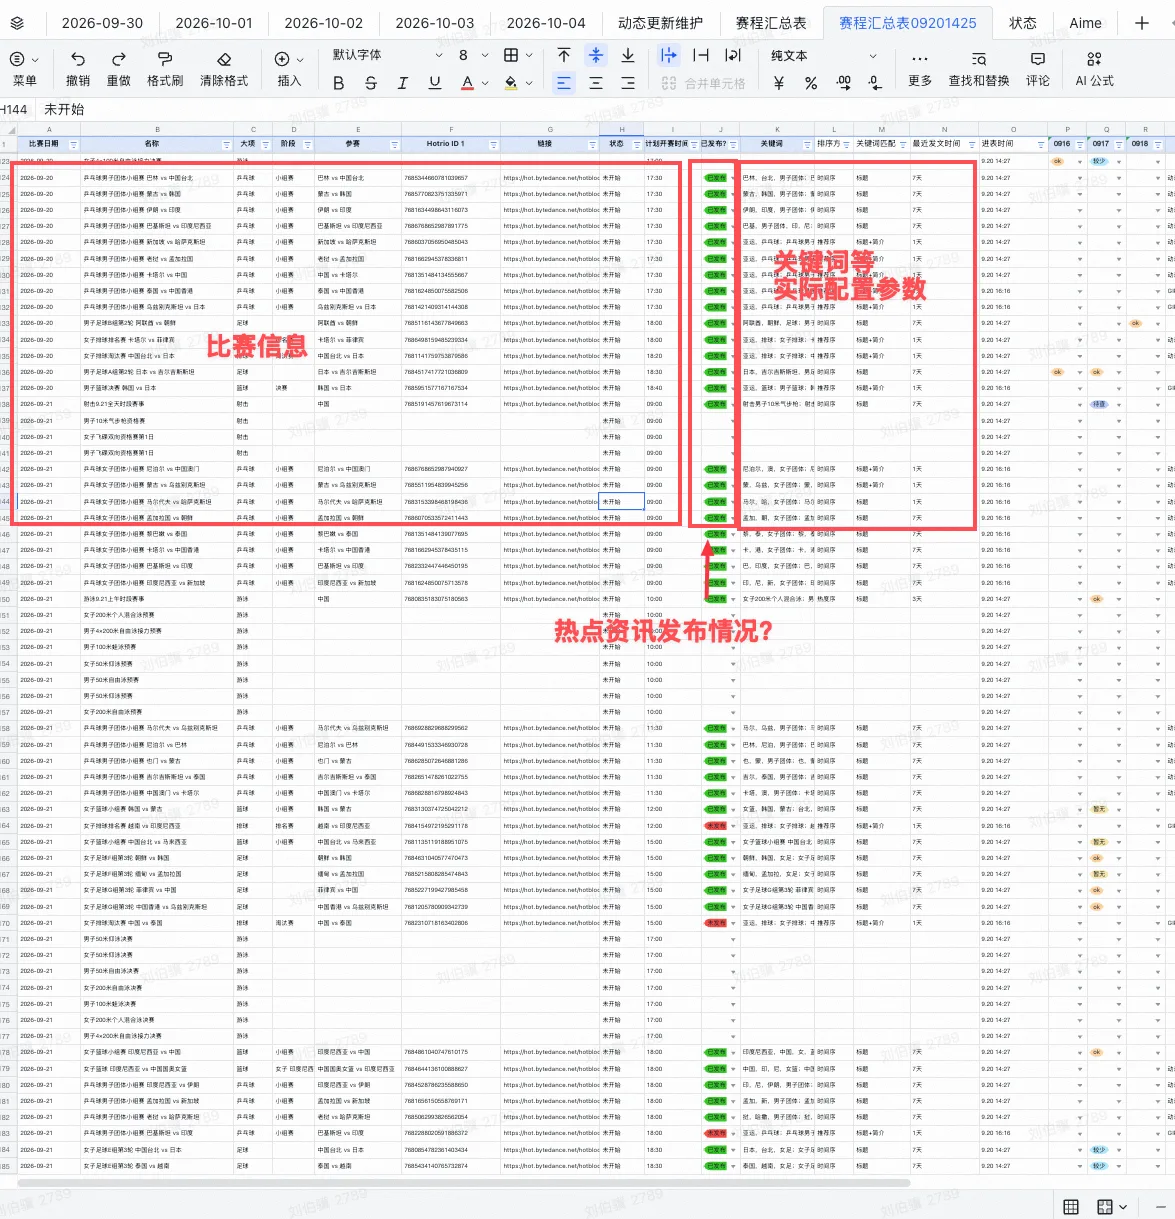 | 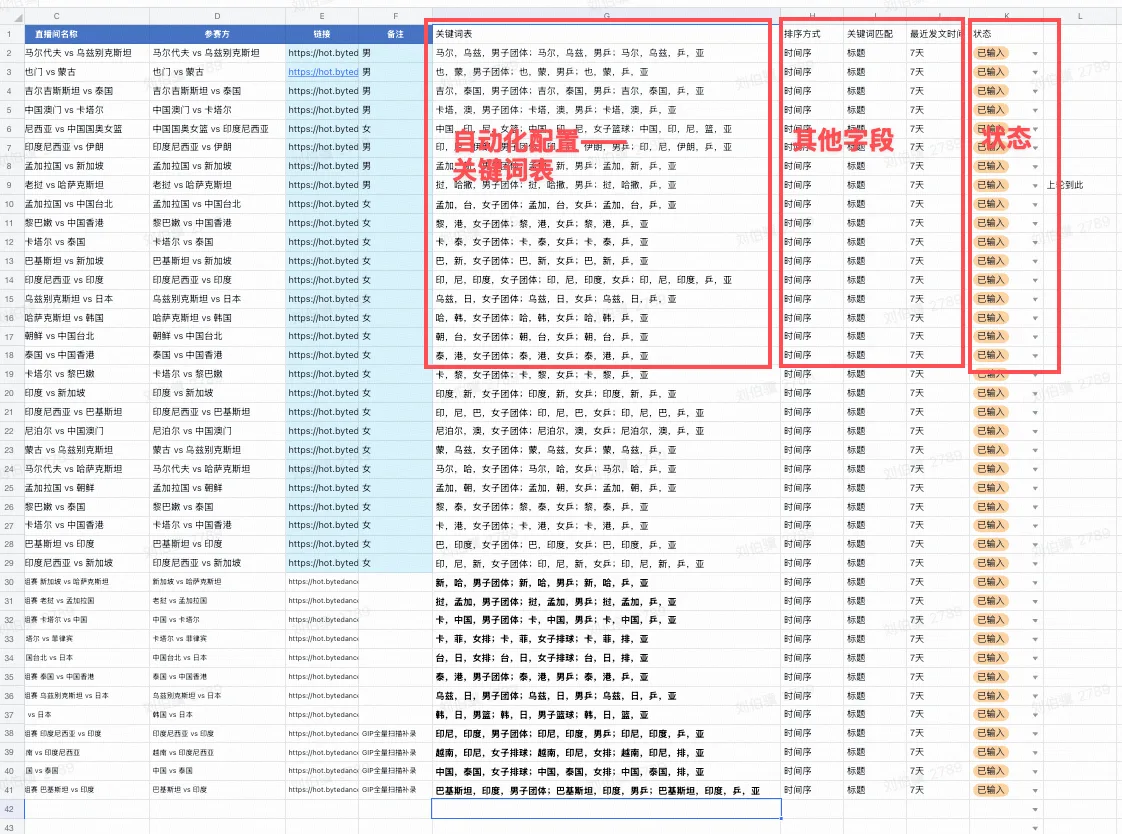 |
总收益
名古屋亚运期间,这套 skill 被调用 30+ 次,累计完成 1,200+ 条赛事同步、600+ 条配置发布、1,500+ 组关键词处理,累计执行自动保存、发布和历史修复约 837 条次。每条配置包含关键词组、召回逻辑、排序方式、匹配字段和时间范围等完整参数。最终实现主表发布状态空值 0 条、日期时间逆序 0 条、配置发布回读通过率 100%。运行效率从早期约 5.54 分钟/条降至稳定阶段约 1.3–1.5 分钟/条,页面映射环节从约 137 秒优化到 API 端约 5.1 秒,提速约 27 倍。
按人工投入基线估算,项目累计减少人工操作约 60 人时。净收益按“传统手工操作时间 − 开发迭代投入 − 启动与检查投入”计算:扣除约 20–32 人时功能研发投入及启动、验收、异常检查成本后,预计仍净节省约 20–35 人时;后续每次增量运行继续产生节省。节省的时间用于项目复盘和沉淀 SOP、形成 Skills 的可复用经验,可直接迁移到后续工作中。
4 人与AI的协作边界
分工 | 适合的环节 | 人的主要工作 |
AI 主做 人验收 |
| 同步信息、定义规则、定义验收协议 抽查质量、处理异常、优化迭代 后续分析 |
AI 与人共同推进 | 规则整理、项目知识维护、评价标准优化、方案比较 | 取精去糟 决策 |
人主导 AI 辅助 |
| 决策 约束 协调 创造 审美 承担责任 |
需要人的场景 / 建立预期:不期待 AI 完成的好,不诉诸 AI 工具
工作或条件 | 原因 | 例子和处理方式 |
最终策略和价值边界拍板 | 涉及取舍、优先级与责任 | AI 比较方案,人决定召回范围、质量底线和资源投入 |
复杂跨团队协调 | 依赖资源承诺、历史关系和未记录的信息 | AI 整理方案与待确认问题,人完成沟通和承诺 |
精确尺寸或几何约束的视觉交付 | 需要可测量、可编辑的结果 | AI 生成构思;尺寸、字体、曲线用设计工具落实和校验 |
仅凭指标变化判断因果 | 趋势本身不足以确认原因 | AI 提出候选解释和查数计划,再用数据或实验验证 |
输入严重不足 | 缺失的信息无法靠提示词补出 | 视频缺画面、OCR 或 ASR 时,先补内容再做完整评估 |
极低频且很快能做完的工作 | 搭建和验收可能比手工更耗时 | 直接完成,或只让 AI 辅助其中一个步骤 |
人工介入 / 在关键节点:信息、行为对齐、约束、评审、迭代
投入评估与产出评估
- 投入评估。在决定是否要项目级管理一个需求时,请考虑整理 ROI——AI项目管理、工作流搭建与迭代的时间和精力是否值得投入?
- 一次性小任务可以直接聊天;长期项目,值得投入时间整理背景和标准,耐心同步减少重复解释和返工
- 算成本账:人力收益(h) = 传统工作方式(h) - 预期投入时间(h) - 新方式投入时间(h) + AI工具使用经验(难以量化的复利部分:初期摸索学习成本高,跑通流程、沉淀能力后,此后的协作将提速)
- 对 Agent 进行项目级管理有一定代价:思考时间更长、回复速度更慢;不过值得体验一下,收益是不易发觉但有的
- 产出评估。对于 Agent 产出的预测与评估:人工投入是否下降,业务质量是否达标,下一次是否更容易复用。 初期搭建和后续维护也计入成本,任务的频次和规模决定了是否值得持续投入。
- 对于「留背景、留错误」的检验原则:开启一个新窗口 / 新Agent,它能否仅凭一个入口文件了解项目现状、立即启动新任务?
- 对于「留流程」的检验原则:SOP / Skills 能否端到端执行,达到可用/好用?
5 AI 工具与模型选择
AI 工具的三个层级
层级 | 定义 | 典型产品 | 能力 | 人 | 示例 |
|---|---|---|---|---|---|
L1 多轮对话 | 通过连续问答理解需求,提供答案、建议或内容 | DeepSeek、Kimi、豆包、ChatGPT |
| 任务、角色 价值观、约束 明确产出形态 | “给我分析、解释这些材料,总结。” |
L2 任务 Agent | 接收工作目标,自主规划步骤、调用工具并交付成果 | 豆包工作 Aime | + 项目空间与规则 + 观察 + 行动:Tool Calling、MCP、Hook、SubAgent... + 循环 + rules / skills... [+ 定时任务] | 提供目标、资料和权限 中途纠偏,验收成果 | “读取项目资料,分析进度,生成周报和汇报 PPT” |
L3 有开发能力的任务 Agent | 在 L2 基础上,能操作真实开发环境,完成工程任务 | Trae、Codex | + 开发工具(git、编译环境、执行环境、依赖管理、测试等) + 插件能力 + 变更管理(git) [+ 跨聊天协作] [+ 跨会话任务调度] | 明确需求与验收标准 长期交互、创造、迭代 审查实现,决定上线 | “读取编码规则,增加xx需求导出功能,走完整开发流程” |
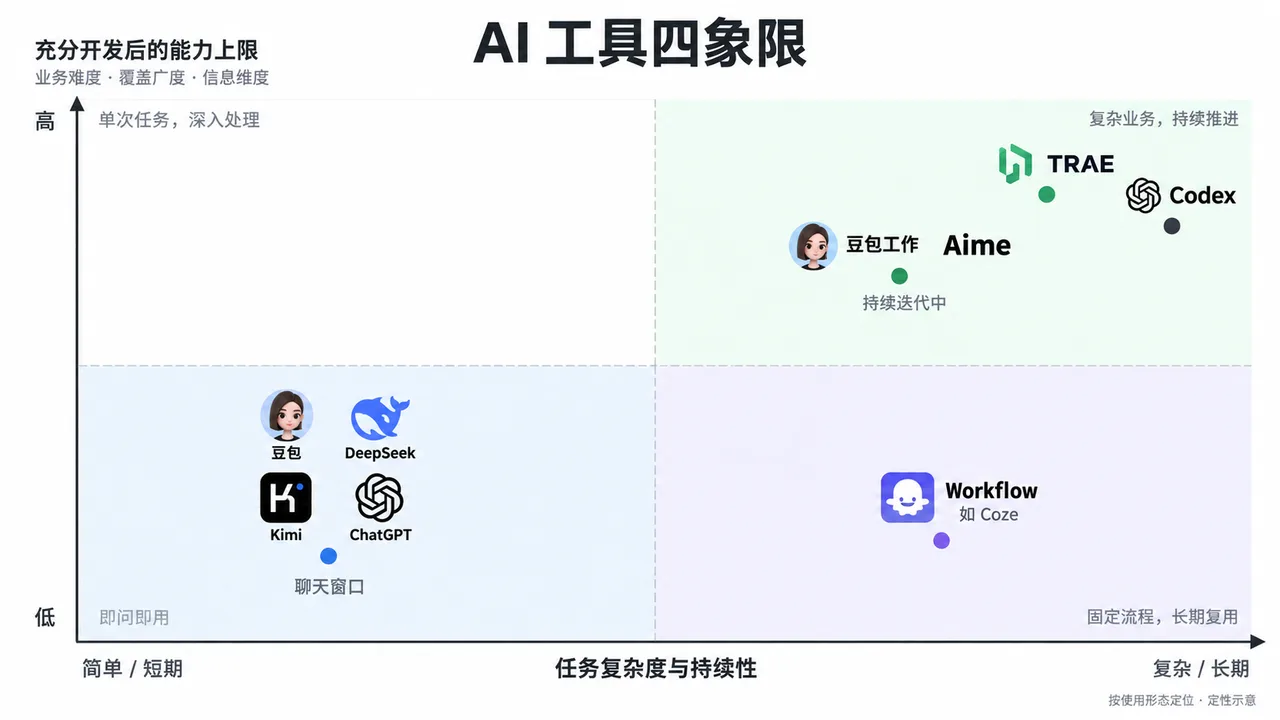
层级 | 层级/工具 | 定位 | 优势 | 缺点/限制 | 适合场景 | 成本 |
L1 聊天页面 | DeepSeek、Kimi、豆包、ChatGPT | 以问答、分析和内容共创为主的 AI 入口 | 上手快;适合快速讨论、解释和多轮润色 | 任务衔接和落地主要靠人;要频繁复制资料、搬运结果 | 知识问答、头脑风暴、文案润色、方案讨论、代码解释 | 费用:0 or 低 门槛:低 |
L2 任务Agent | 豆包工作 | 面向个人与企业的办公任务 Agent,原生接入飞书 | 自动飞书文档与协作上下文;能将产出直接写入飞书(只要你敢) 处于主推/高速迭代期 | 企业能力取决于账号权限和管理员配置; 模型选择有限,复杂任务的人工可控、Agent 调度和产出结果有限。 | 企业资料整理、周报、业务分析、研究报告、汇报材料 | 费用:0(200/月) 门槛:低至中。中-各种功能的熟悉、找到使用场景和对齐成果预期 |
Aime(内部) | 内部任务型 AI 助手 | 模型选择更多 自动的子任务调度 界面简洁美观,保主功能 Aime直接写飞书体验明显优化 | 好模型要排队;执行工具、系统接入与开发能力需按内部版本确认 | 内部任务处理、模型效果对比;具体场景按已接入工具选择 | 费用:内部配额或成本规则待确认;门槛:取决于任务配置,另有排队时间成本 | |
L3 有开发能力的 Agent | TRAE | 融合 IDE 与 Agent 的开发工具,支持人工编辑和自主执行 | 代码编辑IDE与 Agent SOLO方式结合 可在协作过程中查看、修改和验证结果 内部免费 降智不明显,非顶级模型排队可接受 跨聊天协作 移动端远程遥控 Git 版本控制 也可用于非开发的复杂项目 好模型排队问题相对好;可选择上下文大小和effort强度 处于迭代期 | 界面复杂很多,功能更多不一定是好事 顶级模型(GPT6 Astra等)需排队 与 Codex 原生“鞍”差距,智能释放受限 模型/功能更新滞后 | 长期项目管理 软件开发 网页与应用原型 | 费用:内部免费 门槛:中至高。飞书权限需两次授权。产品说明 |
Codex | 以任务委派为中心的工程 Agent,可通过桌面端、CLI、IDE 扩展等入口使用 | 相对 Anthropic 家,大陆友好,近期极少听说封号 移动端远程遥控 项目管理 跨聊天协作 跨会话任务调度 Git 版本控制 UI 简介,UX 优秀 28 天更新计划中 | 企业信息安全 使用受套餐额度限制 at capacity..(莫名限流) 、降智 🪜(我司 VPN 可达) | 仓库开发、问题修复、批量脚本、测试、代码审查、数据处理自动化 | 费用:plus 130元,pro5x 690元,pro10x 1300元;提供额度充值 |
选择模型的建议
- 按工作环节和性质选择模型
- 关键任务:规划,关键操作(merge、整理文档),评审等需创造力、批判性思维、需深度思考与严肃场景,选择"Ultra"模型(GPT6 Astra)
- 执行任务:任务明确、边界清晰、无需创造力的执行性工作,选择"Lite"模型(GPT 6 Luna)
- 参考 Artificial Analysis 报告 智能 v.s. 性价比(Pareto line)
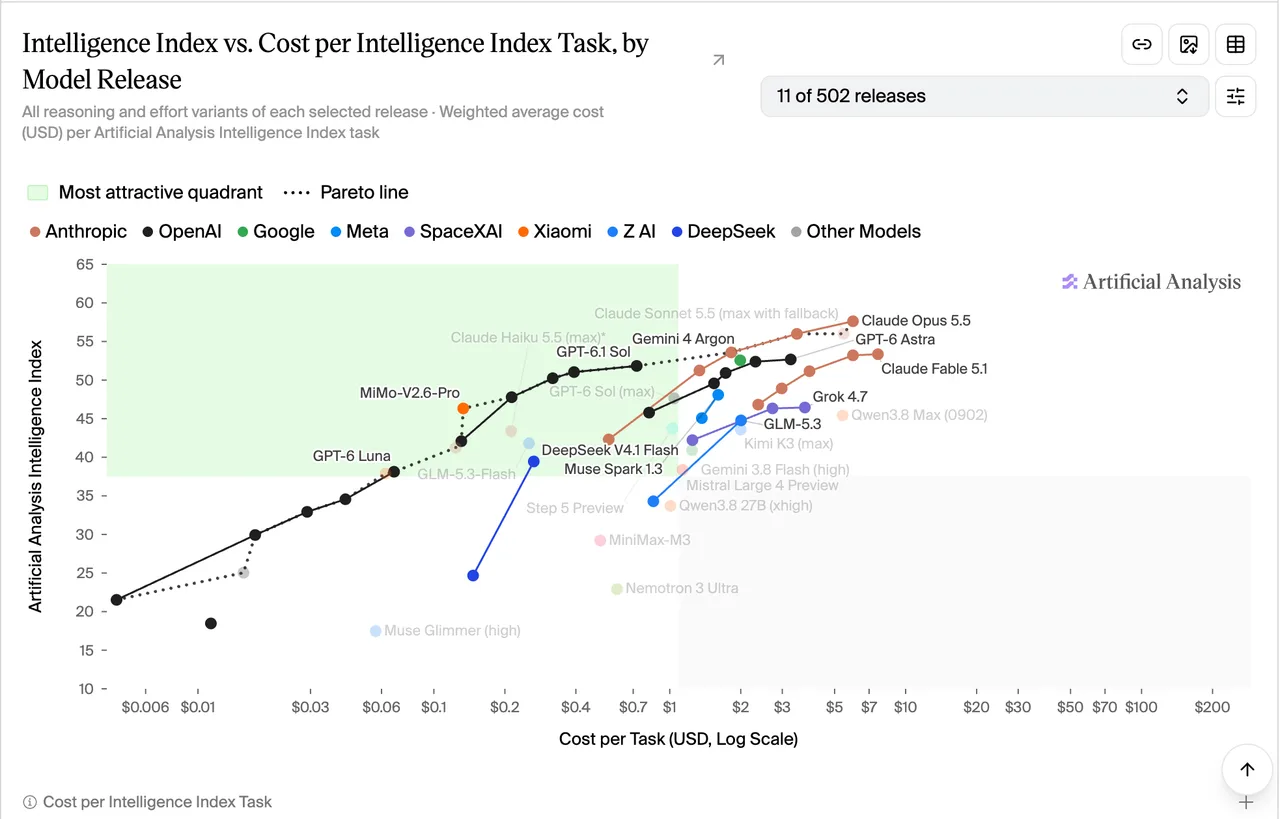
- 了解各模型的风格与优劣势领域:
- Luna 模型便宜、快、善于执行、不过度做工 -> 适合机械重复工作
- Astra 模型贵、慢、具有顶尖智能
- Opus 模型易封号,但拥有顶级智能+视频生成能力
- Anthropic 家性价比更高(同级订阅相对 O/ 用量体感3-4倍),但(极)易封号
最近的思考——对大模型与AI工具
- 多用,半玩半用,积累经验
- 流程清晰、简单重复工作尝试交给 AI
- 情绪管理:
- 前期趁着“兴头儿”广泛、积极地体验,把产出当作惊喜而非预期
- 中期警惕高估其能力,警惕陷入重度依赖,逐渐形成清晰的人与AI分工,理解哪些工作必须慢下来亲自处理——特别是复杂项目管理。
- 长期收敛精准的能力预期。
- 项目规则与约束最好全部心中有数:唯一权威原则;不让约束成为负担;间接控制了数量
- 复杂项目做好协作瓶颈在某一天会爆发的预期;推迟它必做的工作之一是定期花时间和精力整理项目规则、不断优化项目管理流程。
- 通过长期、深度、广泛地使用,慢慢迭代人xAI工具的协作方式,建立和对齐对模型和技术的能力理解
- 学习的模式转变:从按部就班、被动的地毯式学习,到快速建立宏观框架与生产实践需求驱动的即用即学。
6 答疑与批评指正
思考:目前正在 AI 协作维护的项目,有没有遇到瓶颈?
联想:一个可搭建工作流的场景?可行性?怎么拆解?怎么迭代?
恳请收到大家的反馈和意见 🙏 🙇♂️
QA(WIP)
让给Agent传递的关键信息能被Agent自己管理起来,而不是淹没在聊天记录中被遗忘。
+skills、rules是什么样?
A:它们可以是自己电脑里能打开、能编辑的文件;也可以是
例如,一个“周报整理”技能可以长这样:
weekly-report/
├── SKILL.md        使用条件、处理步骤、输出要求
├── template.md     周报模板(可选)
└── examples/       好的成品示例(可选)
https://antigravity.google/docs/skills/
技能是用于扩展 Agent 功能的 开放标准。技能是一个包含
SKILL.md文件的文件夹,其中包含 Agent 在执行特定任务时可以遵循的说明。
附-rules与skills
| 类型 | 作用 | 例子 |
|---|---|---|
| Rules:工作规则 | 告诉 Agent 平时应该遵守什么 | 默认中文;结论附来源;输出放到指定目录 |
| Skills:任务技能 | 告诉 Agent 某一类任务怎么做 | 如何整理周报、分析评测数据、生成研究报告 |
+字节内部 skills 平台?
【学习中】
+skills如何形成的、我的工作和agent的工作、skills在哪、什么样、怎么复用...
推荐从一个真实任务开始:完成任务 → 纠正结果 → 总结有效步骤 → 保存为 Skill → 换一份材料验证。
| 你负责 | Agent 负责 |
|---|---|
| 说明目标,提供材料或成品示例 | 读取材料,梳理步骤,执行处理 |
| 告诉 Agent 每一步都怎么做,输入什么->怎么处理->拿到什么结果 | 把你教给它的“实操”一遍,先学会基本版,自己记录下来 |
| 判断结果是否符合业务要求 | 根据反馈修改,提炼可复用流程 |
| 指出哪些经验值得保留 | 编写技能文件、模板和必要脚本;探索更优路径 |
+如何创建项目、添加本地文件夹
+设法减轻负担,特别是模版信息输入;模版输入版块再精简、给出实际填写例子
+Aime中项目维护流程
|
|
|
|
1.1 创建项目 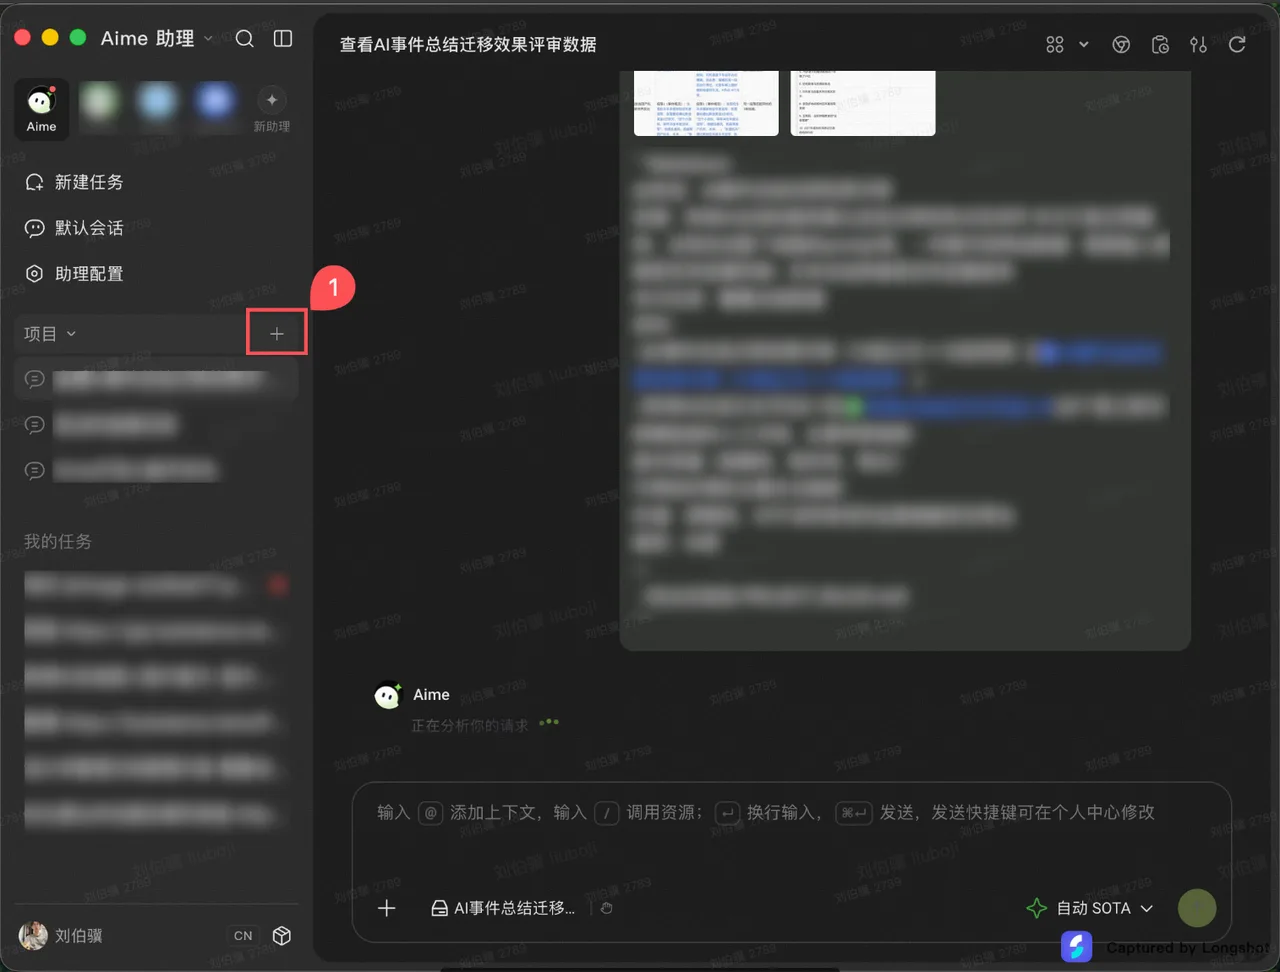 1.2 可以起一个合适的名字 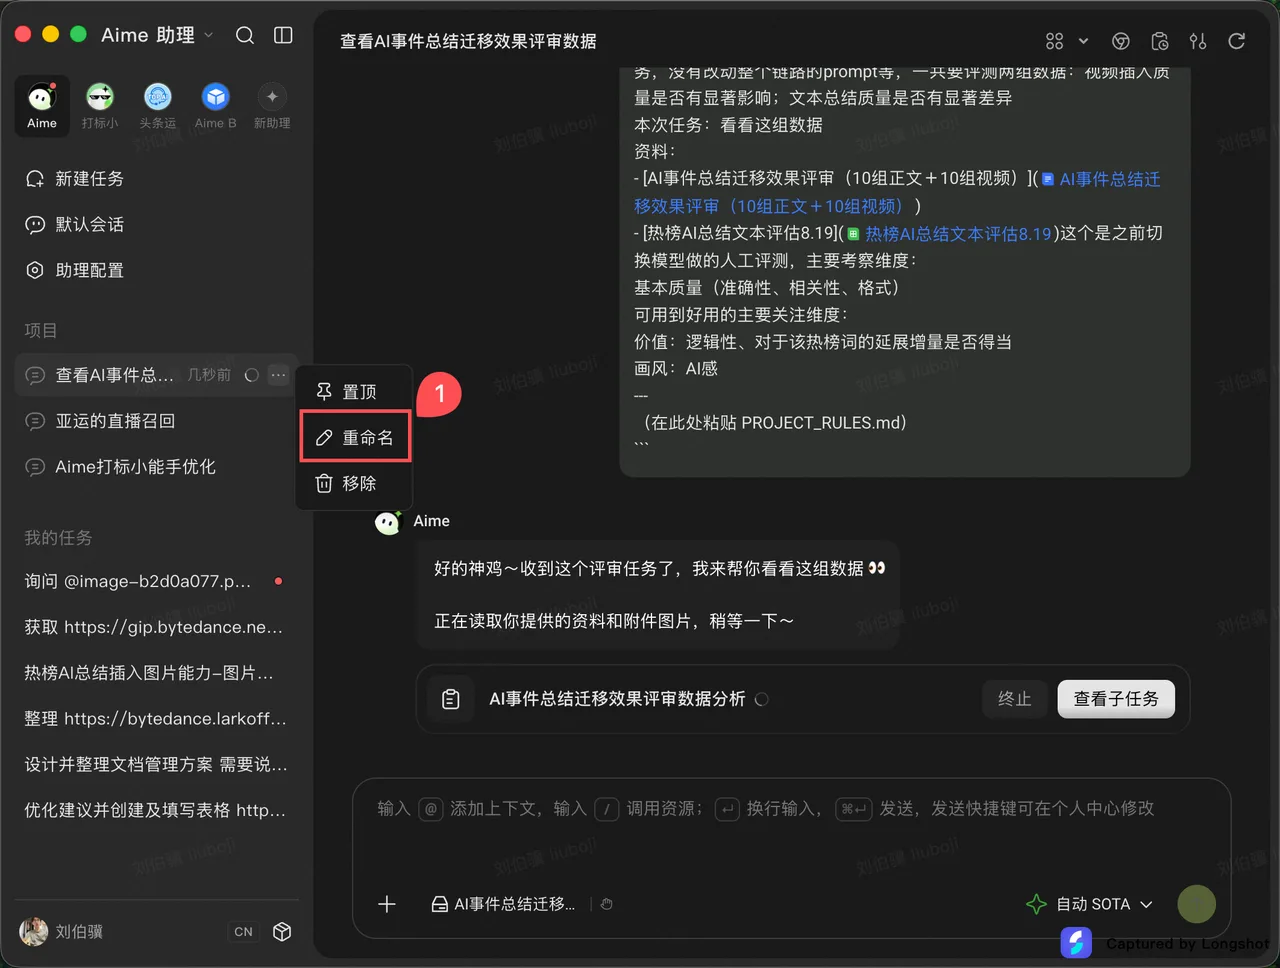 | 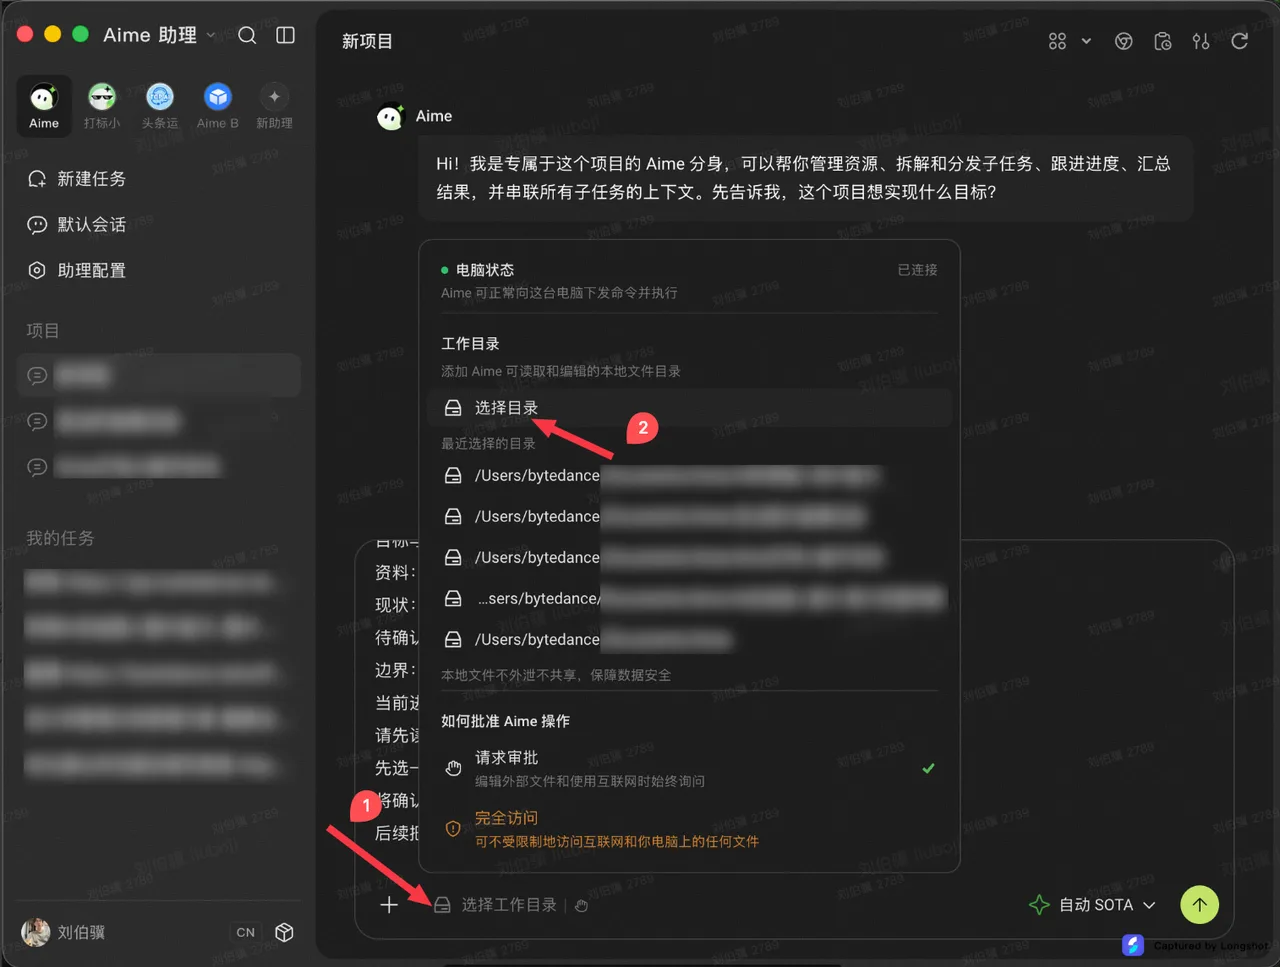 创建新目录 or 选择已有目录 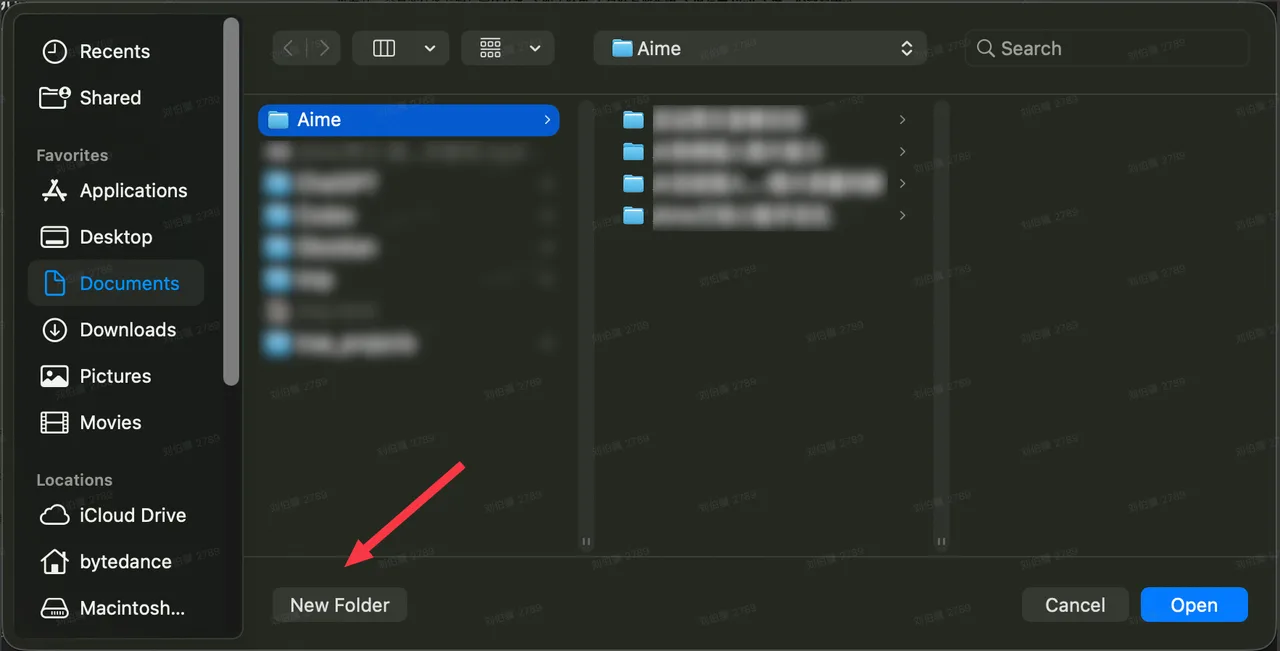 | 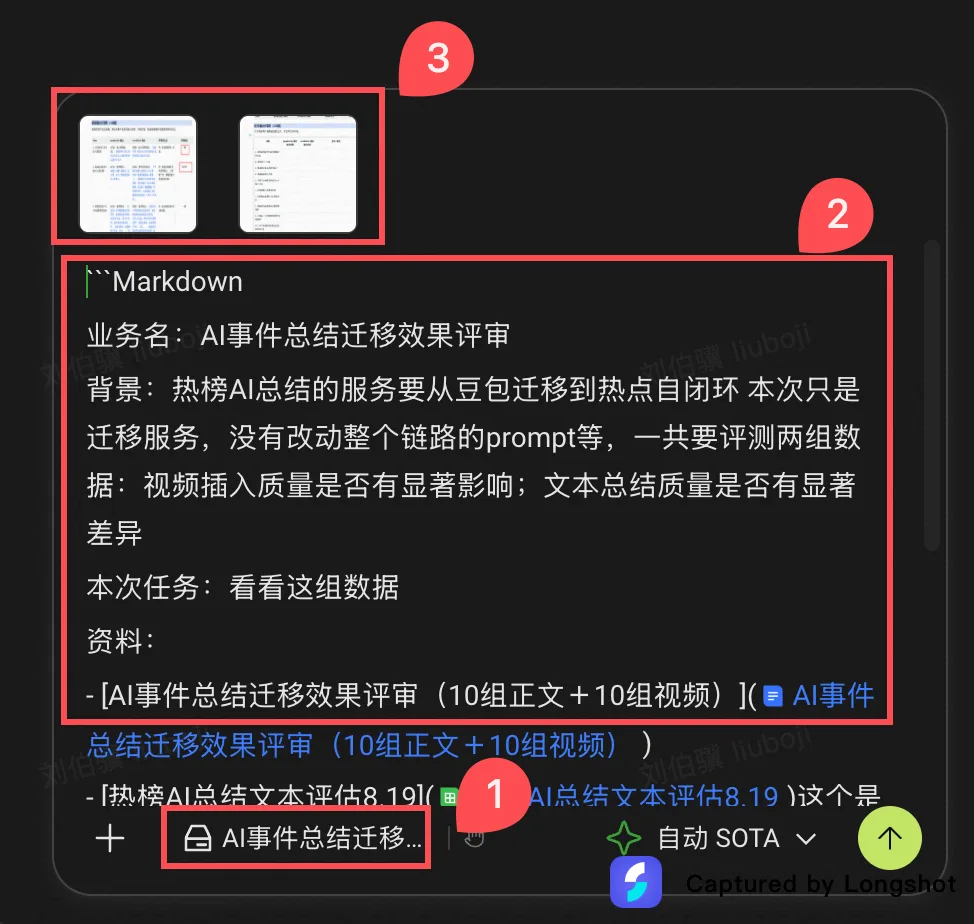
| 随意开启工作交互~ |
+简单场景快速用起来——以「AI事件总结迁移效果评审」为例
- 发出的第一条信息
第一条信息
业务名:AI事件总结迁移效果评审
背景:热榜AI总结的服务要从豆包迁移到热点自闭环 本次只是迁移服务,没有改动整个链路的prompt等,一共要评测两组数据:视频插入质量是否有显著影响;文本总结质量是否有显著差异
本次任务:看看这组数据
资料:
- [AI事件总结迁移效果评审(10组正文+10组视频)](https://bytedance.larkoffice.com/docx/YV1odva7PonT0UxIH92cSB1nnbg)
- [热榜AI总结文本评估8.19](https://bytedance.larkoffice.com/sheets/CEXvsoAMFhiTiOtBKe5cp6vSngh)这个是之前切换模型做的人工评测,主要考察维度:
基本质量(准确性、相关性、格式)
可用到好用的主要关注维度:价值:逻辑性、对于该热榜词的延展增量是否得当;画风:AI感

请先读取任务相关资料,复述你的理解,区分事实和假设。
请你仔细阅读资料,特别是飞书文档,要求在给定文档基础上下探一层,收集重要信息,维护进项目知识。最新现状与历史记录需要明确标记。
后续把重要规则、决定、错误和当前状态维护到项目文件中。

---
(在此处粘贴 PROJECT_RULES.md。太长了此处省略)- Aime的首条输出:
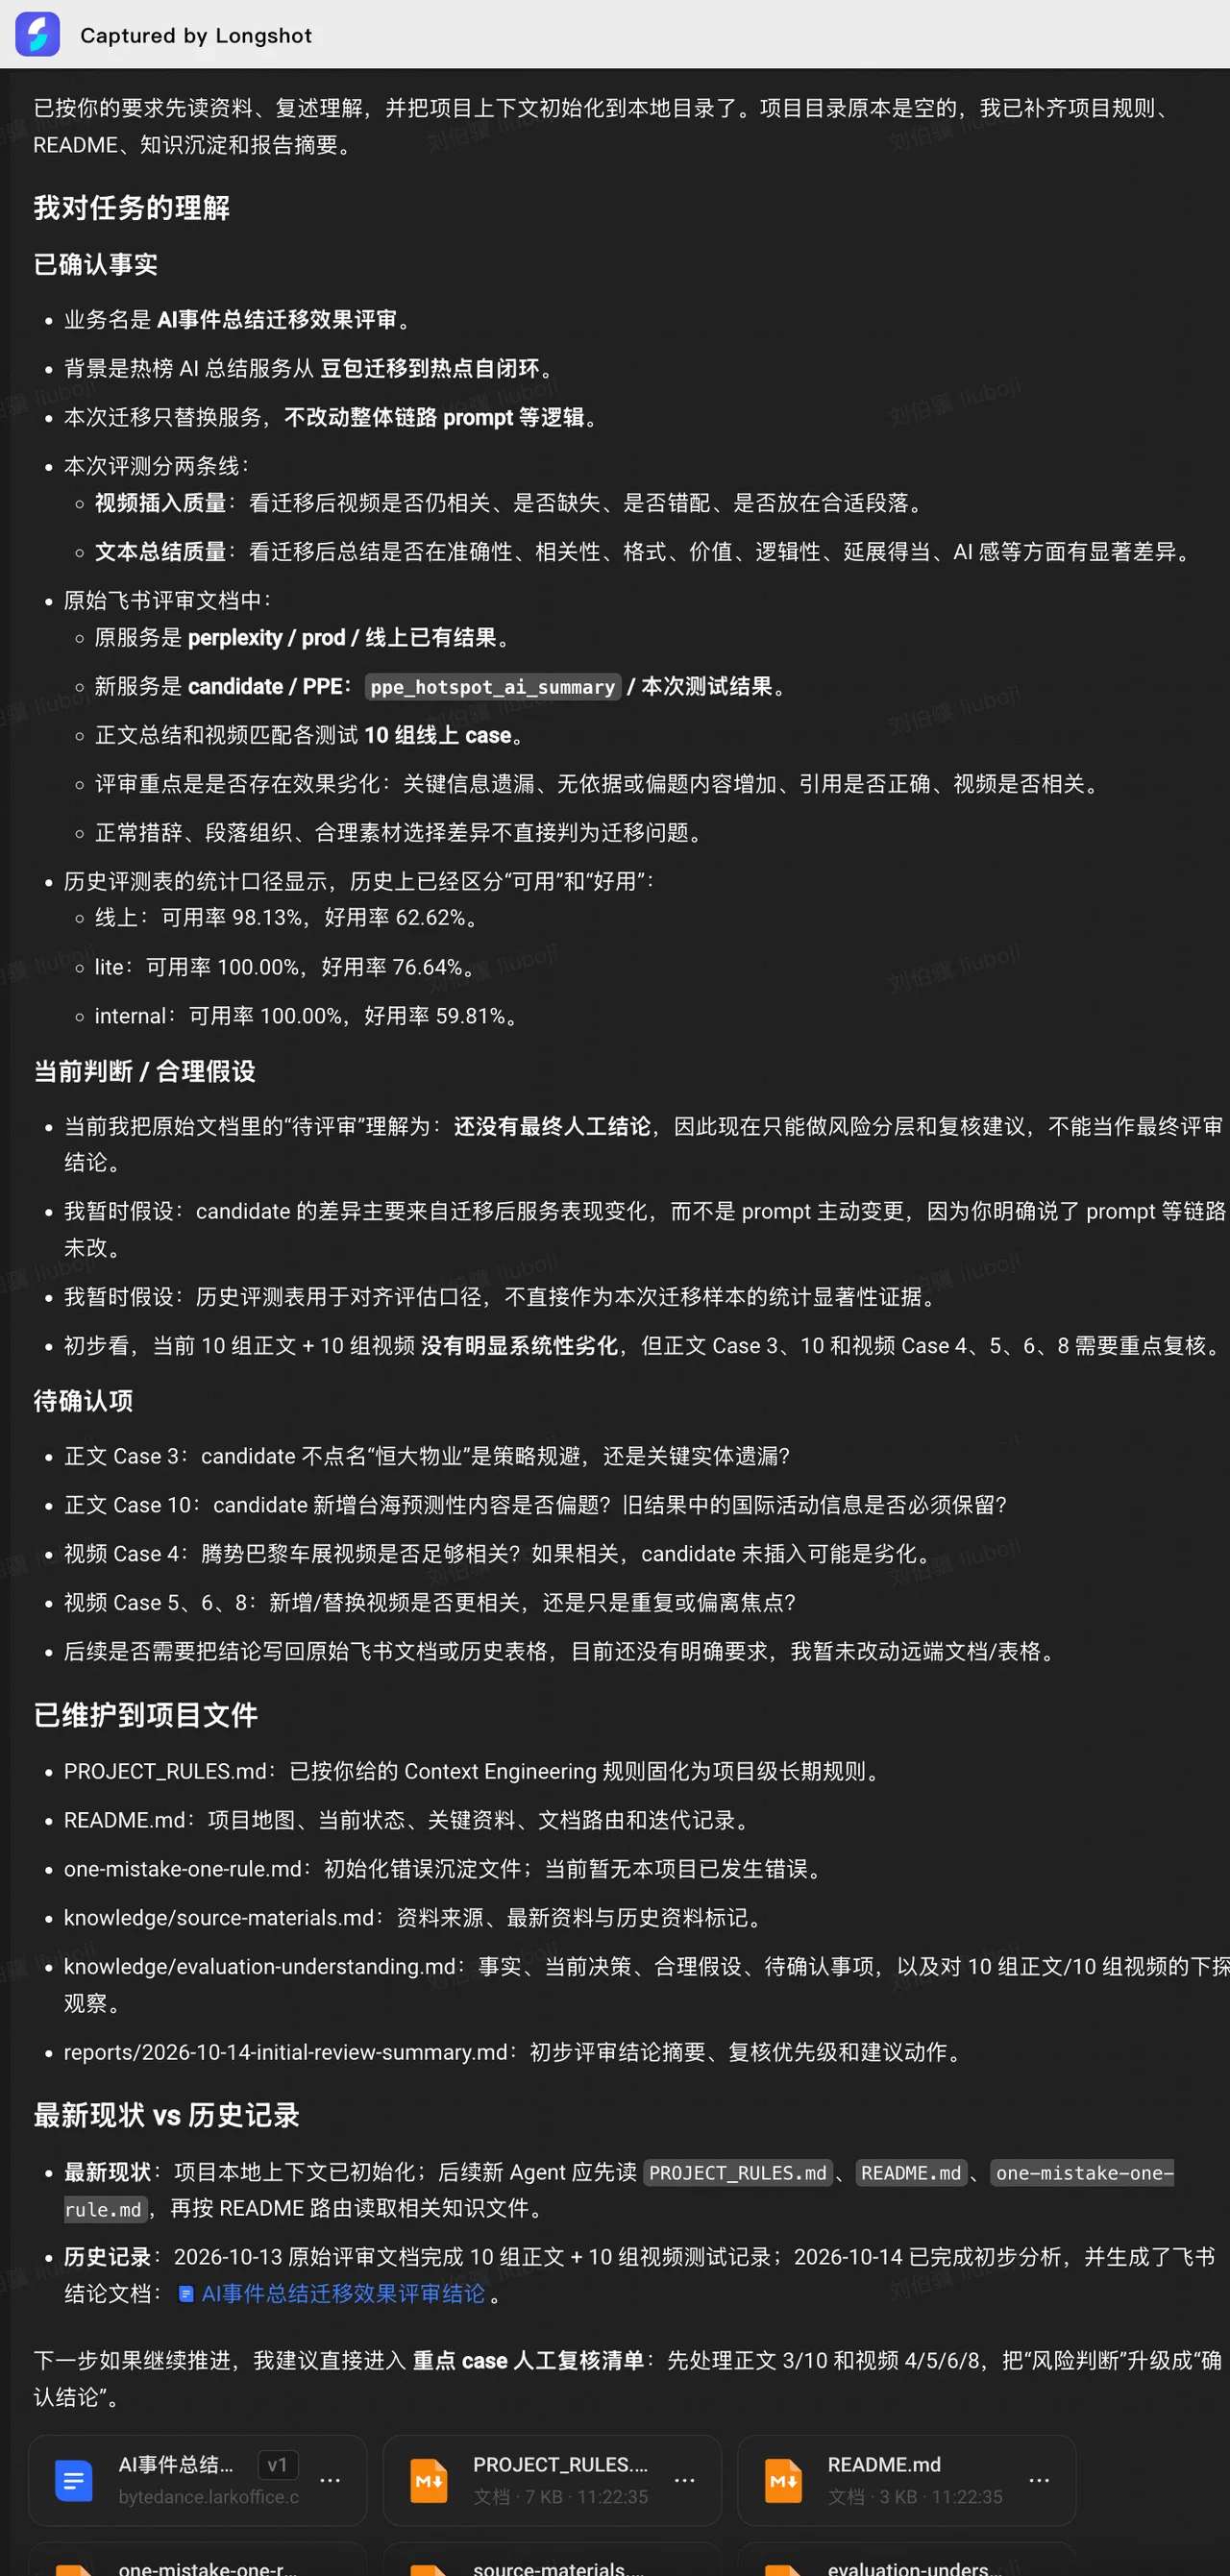
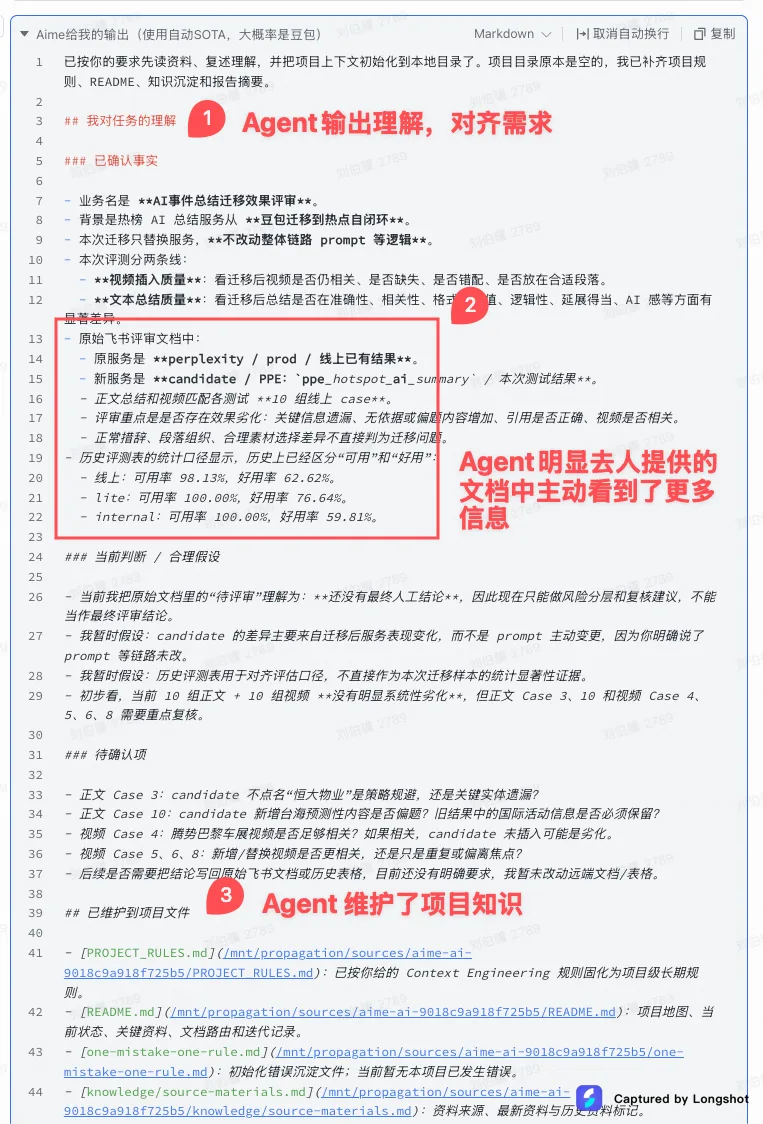
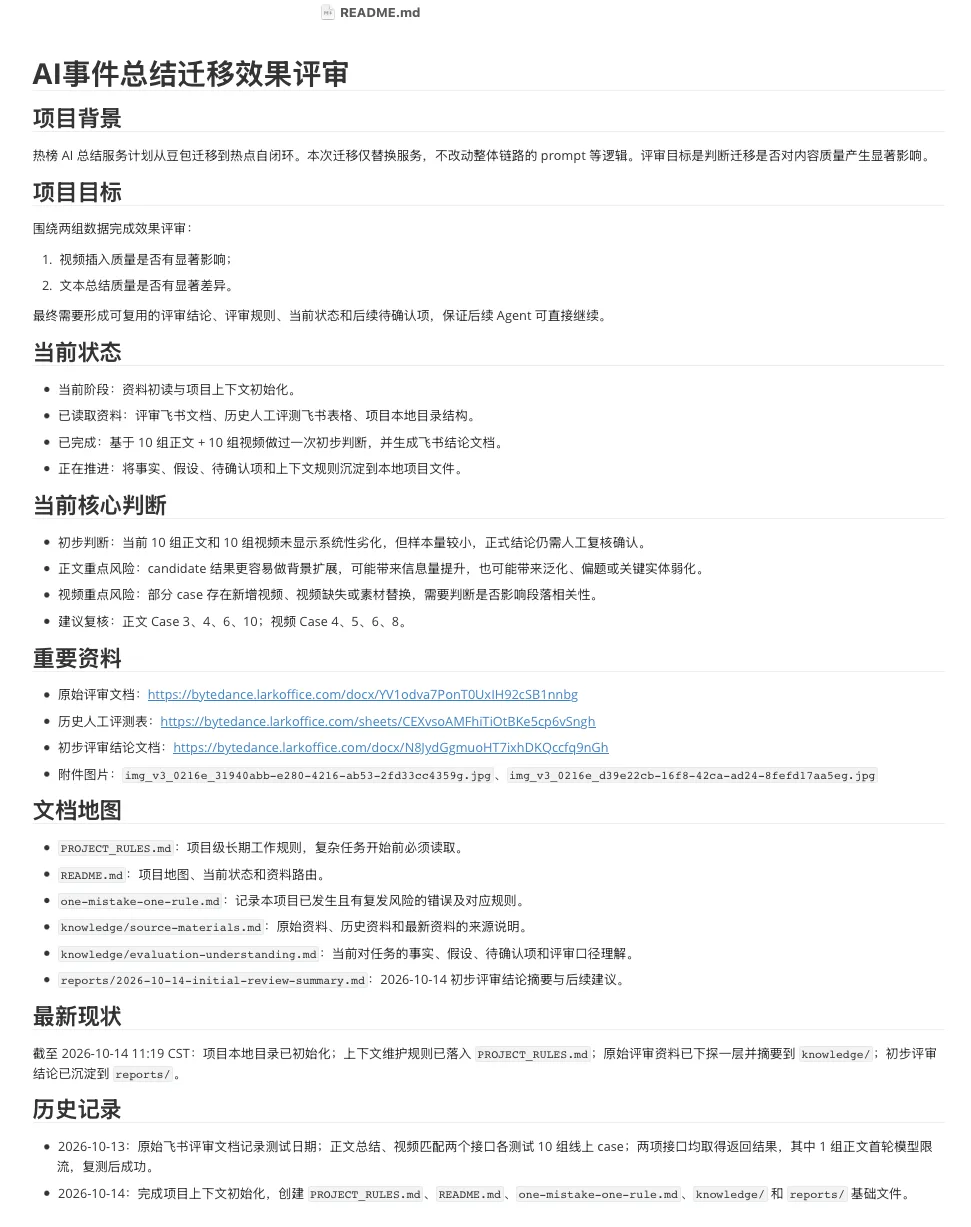
Aime 创建的 README.md
Aime创建的README.md
# AI事件总结迁移效果评审

## 项目背景

热榜 AI 总结服务计划从豆包迁移到热点自闭环。本次迁移仅替换服务,不改动整体链路的 prompt 等逻辑。评审目标是判断迁移是否对内容质量产生显著影响。

## 项目目标

围绕两组数据完成效果评审:

1. 视频插入质量是否有显著影响;
2. 文本总结质量是否有显著差异。

最终需要形成可复用的评审结论、评审规则、当前状态和后续待确认项,保证后续 Agent 可直接继续。

## 当前状态

- 当前阶段:资料初读与项目上下文初始化。
- 已读取资料:评审飞书文档、历史人工评测飞书表格、项目本地目录结构。
- 已完成:基于 10 组正文 + 10 组视频做过一次初步判断,并生成飞书结论文档。
- 正在推进:将事实、假设、待确认项和上下文规则沉淀到本地项目文件。

## 当前核心判断

- 初步判断:当前 10 组正文和 10 组视频未显示系统性劣化,但样本量较小,正式结论仍需人工复核确认。
- 正文重点风险:candidate 结果更容易做背景扩展,可能带来信息量提升,也可能带来泛化、偏题或关键实体弱化。
- 视频重点风险:部分 case 存在新增视频、视频缺失或素材替换,需要判断是否影响段落相关性。
- 建议复核:正文 Case 3、4、6、10;视频 Case 4、5、6、8。

## 重要资料

- 原始评审文档:<https://bytedance.larkoffice.com/docx/YV1odva7PonT0UxIH92cSB1nnbg>
- 历史人工评测表:<https://bytedance.larkoffice.com/sheets/CEXvsoAMFhiTiOtBKe5cp6vSngh>
- 初步评审结论文档:<https://bytedance.larkoffice.com/docx/N8JydGgmuoHT7ixhDKQccfq9nGh>
- 附件图片:`img_v3_0216e_31940abb-e280-4216-ab53-2fd33cc4359g.jpg`、`img_v3_0216e_d39e22cb-16f8-42ca-ad24-8fefd17aa5eg.jpg`

## 文档地图

- `PROJECT_RULES.md`:项目级长期工作规则,复杂任务开始前必须读取。
- `README.md`:项目地图、当前状态和资料路由。
- `one-mistake-one-rule.md`:记录本项目已发生且有复发风险的错误及对应规则。
- `knowledge/source-materials.md`:原始资料、历史资料和最新资料的来源说明。
- `knowledge/evaluation-understanding.md`:当前对任务的事实、假设、待确认项和评审口径理解。
- `reports/2026-10-14-initial-review-summary.md`:2026-10-14 初步评审结论摘要与后续建议。

## 最新现状

截至 2026-10-14 11:19 CST:项目本地目录已初始化;上下文维护规则已落入 `PROJECT_RULES.md`;原始评审资料已下探一层并摘要到 `knowledge/`;初步评审结论已沉淀到 `reports/`。

## 历史记录

- 2026-10-13:原始飞书评审文档记录测试日期;正文总结、视频匹配两个接口各测试 10 组线上 case;两项接口均取得返回结果,其中 1 组正文首轮模型限流,复测后成功。
- 2026-10-14:完成项目上下文初始化,创建 `PROJECT_RULES.md`、`README.md`、`one-mistake-one-rule.md`、`knowledge/` 和 `reports/` 基础文件。